Когда модели нужно «посмотреть весь проект», начинается ручная работа: открыть каталоги, выбрать файлы, склеить в один текст, не забыть про пути и не превысить контекст. ctf-collect-to-file 4.1.0 делает это одной командой — собирает код в один документ с относительными путями, фильтрами по расширениям и жёстким бюджетом токенов. Ниже — что умеет, что показали прогоны на Windows и Linux и на каких двух ловушках Windows спотыкается установка.

TL;DR: одна команда и три решения
- Что это. Bash-утилита: обходит дерево, отбирает файлы по правилам, склеивает в один документ.
- Форматы. Markdown с оглавлением, JSON, JSONL, обычный текст.
- Бюджет.
--token-budgetоценивает объём как «байты / 4» и либо обрезает файл, либо выбрасывает его. - Плохой ввод отсекается. Исключения VCS, зависимостей и сборки включены по умолчанию.
- Проверка.
--dry-runпоказывает список без записи,--statsпечатает машиночитаемые числа.
ctf -e md,sh --token-budget 2000 --toc src out.md
ctf -e sh -n .            # только список, без записи
ctf -e sh --stats .       # числа и выход
Проблема, которую это решает
Контекст модели — ограниченный ресурс, и тратить его на мусор обидно. В любом проекте есть node_modules, .git, каталоги сборки, логи и гигабайты картинок; если сложить всё подряд, документ окажется бесполезным.
Ручная склейка тоже плоха: она невоспроизводима. Сегодня собрали двенадцать файлов, завтра — четырнадцать, и никто не помнит, каких не хватало. А без относительных путей модель не может сослаться на файл, и ответы вроде «в этом файле на строке 40» теряют смысл.
Утилита решает три задачи сразу: отбор (что именно попадает), бюджет (сколько это стоит в токенах) и структура (оглавление, метаданные, пути относительно корня).
Что такое ctf-collect-to-file
flowchart TB
  TREE["дерево исходников"] --> SEL["отбор: расширения, include, exclude, git"]
  SEL --> SORT["порядок: путь, имя, размер, mtime"]
  SORT --> BUD["бюджет токенов и пределы размера"]
  BUD --> FMT["формат: md, json, jsonl, txt"]
  FMT --> OUT["один документ для модели"]
| Свойство | Значение |
|---|---|
| Тип | bash-утилита, один файл ctf.sh |
| Версия в разборе | 4.1.0 |
| Рантайм | bash; есть порты для PowerShell и cmd |
| Форматы вывода | md, json, jsonl, txt |
| Зависимости | базовые утилиты; sha256sum нужен для --dedup |
| Лицензия | MIT |
Отдельно стоит сказать про порты. ctf.ps1 повторяет поведение bash-версии на PowerShell, ctf.bat — тонкая обёртка для cmd.exe. Набор опций совпадает с точностью до названий, и это отдельный пункт документации: расхождение имён между портами — источник ошибок при переносе скриптов.
Возможности
Отбор файлов
| Опция | Что делает |
|---|---|
-e, --ext |
расширения списком, можно повторять, точка необязательна |
-E, --exclude |
исключение по маске, звёздочка пересекает слэш |
-I, --include |
оставить только совпавшие пути |
--exclude-dir |
исключить имя каталога на любой глубине |
--no-default-excludes |
отключить встроенные исключения |
--list-default-excludes |
показать встроенные списки и выйти |
-d, --max-depth |
ограничение глубины |
--max-size, --min-size |
пределы размера файла |
--files-from |
список файлов из файла или stdin |
--git tracked\|all |
перечисление через git с учётом .gitignore |
Встроенные исключения — то, ради чего утилиту и берут: они избавляют от node_modules, .git и каталогов сборки без единой дополнительной опции. Если нужно ровно наоборот — есть --no-default-excludes.
Формат документа
| Опция | Что делает |
|---|---|
-F, --format |
md, json, jsonl, txt |
--toc |
оглавление со ссылками в стиле GitHub |
--metadata |
комментарий на файл: байты, строки, первые символы хеша |
--line-numbers |
нумерация строк внутри блоков |
--heading-level |
уровень заголовка для пути |
--path-style |
относительные пути (по умолчанию) или абсолютные |
--sort |
порядок: путь, имя, размер, время изменения |
--no-timestamp |
убрать метку времени для воспроизводимого вывода |
--dedup |
одинаковые файлы выводятся один раз |
--no-timestamp и --dedup вместе дают воспроизводимый результат: два прогона по одному дереву дают одинаковый файл, и его можно сравнивать и хранить в репозитории.
Бюджет и поведение
flowchart TD
  OPT["опции запуска"] --> EX["исключения по умолчанию: VCS, зависимости, сборка"]
  OPT --> BUD2["token-budget: обрезать или выбросить"]
  OPT --> SIZE["max-size: не тащить гигантов"]
  EX --> RES["итоговый набор файлов"]
  BUD2 --> RES
  SIZE --> RES
| Опция | Что делает |
|---|---|
--token-budget N |
оценка «байты / 4», уложить вывод в бюджет |
--budget-action truncate |
обрезать не влезающий файл по границе строки (по умолчанию) |
--budget-action drop |
выбросить файл целиком и посчитать в статистике |
--truncate-lines N |
оставить не больше N строк на файл |
-n, --dry-run |
только список отобранного, без записи |
--stats |
машиночитаемые числа и выход |
--strict |
код 4, если ничего не собрано |
Про бюджет стоит понимать главное: это оценка, а не измерение. Четверть байта на токен — консервативная величина для кода, и она специально завышает объём, чтобы вывод гарантированно влез. Точное число токенов утилита не считает и не обещает.
Как это работает
flowchart LR
  SRC["каталог"] --> CAND["кандидаты: find или git"]
  CAND --> FILT["фильтрация"]
  FILT --> STATS["статистика: собрано, пропущено, токены"]
  STATS --> DOC["документ с оглавлением и метаданными"]
  DOC --> BUILT["проверка: файл на месте, сумма сходится"]
| Шаг | Что происходит |
|---|---|
| 1 | перечисление файлов: find по умолчанию или git при --git |
| 2 | фильтрация: расширения, include/exclude, размеры, глубина |
| 3 | сортировка по выбранному ключу |
| 4 | укладывание в бюджет: обрезка или выбрасывание |
| 5 | сборка документа с заголовком, оглавлением и итоговой таблицей |
| 6 | итог: сколько собрано, сколько пропущено и почему |
Шестой шаг — главная причина, по которой утилитой удобно пользоваться в конвейере: в конце печатается таблица с числом кандидатов, собранных, пропущенных и причинами пропуска. Это ответ на вопрос «а точно всё попало?», не требующий читать сам документ.
Замеры и цифры
Проверено 12.11.2026, двумя проверками.
| Что проверено | Значение | Где |
|---|---|---|
Архив исходников v4.1.0 |
147 375 байт, SHA-256 ff13457d…37b8a34 |
скачивание тега |
| Файлов в дереве | 42 | подсчёт |
Версия из VERSION и ctf.sh --version |
4.1.0 | прогон |
--version в локальном прогоне |
ctf v4.1.0 |
Windows, Git Bash |
Сборка трёх файлов с фильтром md,sh |
собрано 2, пропущено 1 (причина: расширение) | --stats |
| Размер вывода на наборе из двух файлов | 754 байта, оценка 2 токена | локально |
| Формат JSON | 219 байт, корректный JSON с полем files |
локально |
--version на сервере |
ctf v4.1.0 |
Linux, bs535 |
| Сборка на сервере | вывод 606 байт, 2 раздела в оглавлении | Linux |
--dry-run по тому же набору |
TSV: x.md, y.sh, пропущен z.log |
Linux |
| Прогон по собственному репозиторию | 42 кандидата, 14 отобрано по -e sh |
Linux |

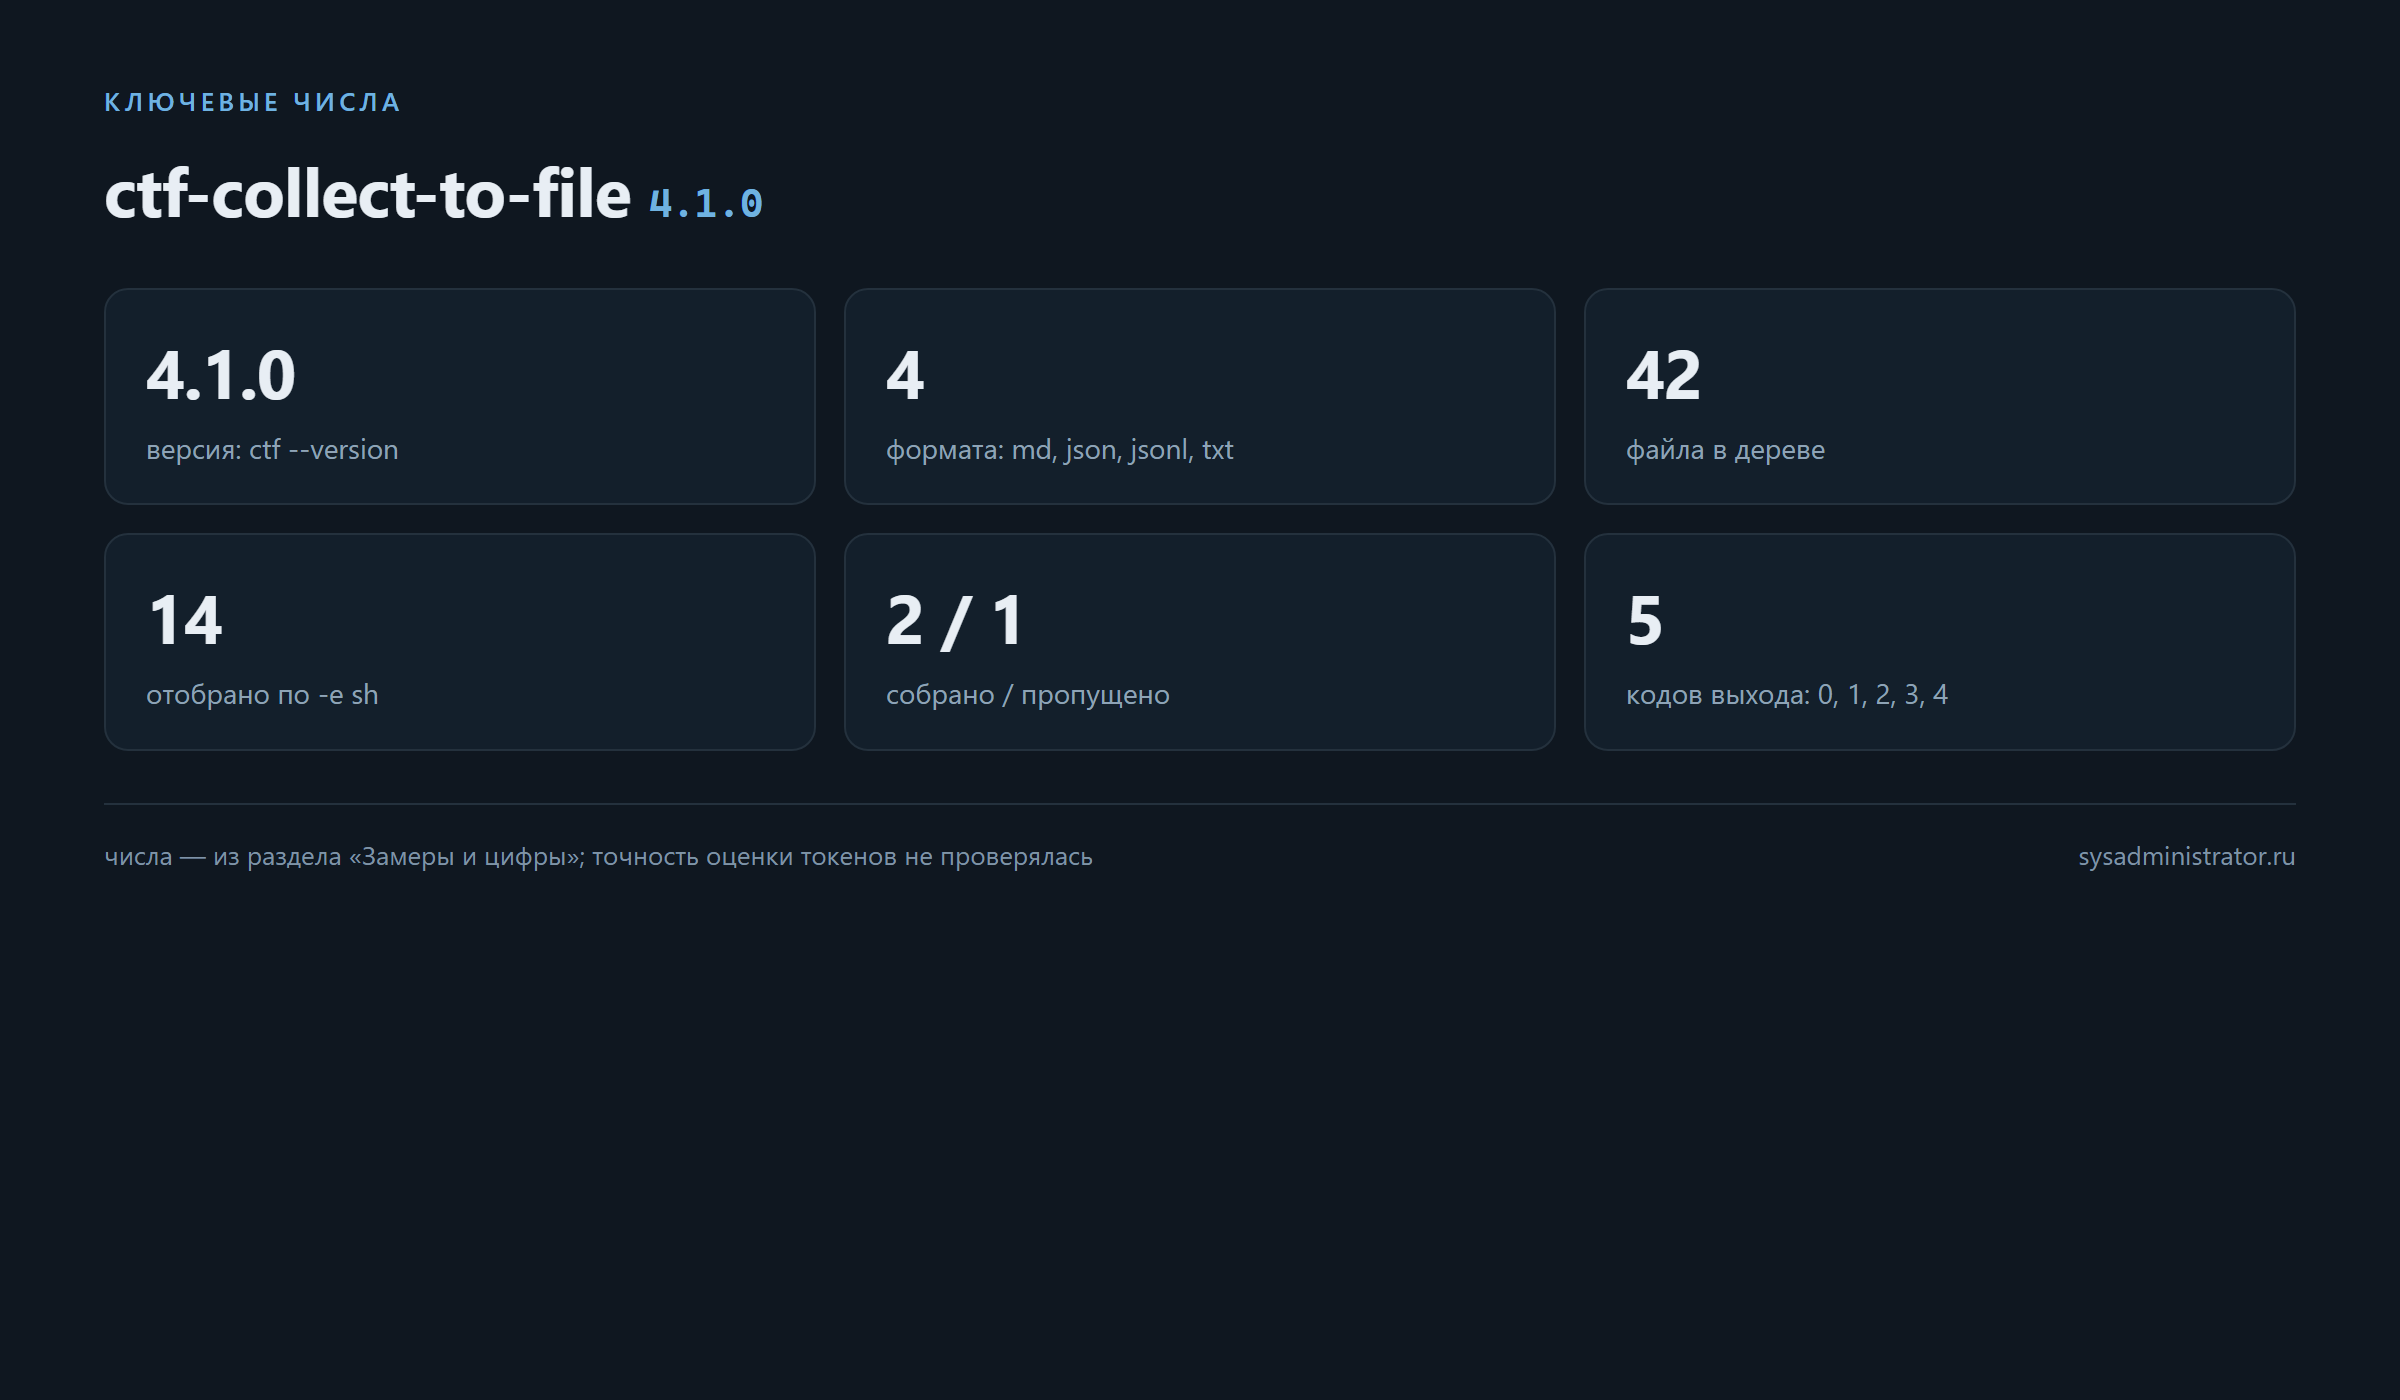
Из этих чисел видно две вещи. Первая: утилита одинаково работает на Windows под Git Bash и на Linux — вывод, оглавление и статистика совпадают по структуре. Вторая: на собственном дереве она честно отсекает нерелевантное: 42 кандидата, 14 отобрано по одному расширению, и самый крупный из отобранных — ctf.sh размером 99 523 байта и 2 222 строки.
Чего замеры не показывают: точности оценки токенов. Для наборов в несколько байт проверить её невозможно, а на большом проекте нужен реальный токенизатор — утилита его не содержит и не заменяет.
Сильные стороны продукта
- Одна команда вместо ручной склейки. И результат воспроизводим: те же опции — тот же файл.
- Встроенные исключения.
node_modules,.gitи каталоги сборки отсекаются без настройки. - Бюджет с двумя стратегиями. Обрезать или выбросить — выбор осознанный, а не жёстко заданный.
- Оглавление и метаданные. Модель видит структуру и может ссылаться на путь.
- Машинные форматы. JSON и JSONL для конвейеров, Markdown для чтения человеком.
- Проверка без записи.
--dry-runпоказывает отбор до того, как что-то создано. - Воспроизводимость.
--no-timestampи--dedupдают одинаковый вывод. - Порты под Windows. PowerShell и
cmd— не «работает через WSL», а свои реализации.
Установка
# bash
git clone https://github.com/paulmann/ctf-collect-to-file.git
cd ctf-collect-to-file
bash install.sh          # ставит ctf в PATH

# Windows
pwsh -File install-ctf.ps1
ctf --version
| Проверка | Признак успеха |
|---|---|
ctf --version |
ctf v4.1.0 |
ctf -e sh -n . |
список файлов, ничего не записано |
ctf --list-default-excludes |
списки исключений и код 0 |
Установщик для Windows создаёт один bin\ctf.cmd, который вызывает движок через pwsh -File. Сделано так не из любви к обёрткам: два «очевидных» варианта раскладки воспроизводятся как дефекты, и оба описаны в заметках к релизу.
Первый: PowerShell предпочитает .ps1 файлу .cmd, поэтому вызов ctf --version привязывает --version к позиционному аргументу «расширение» и запускает сборку вместо печати версии. Второй: отложенное раскрытие переменных в cmd.exe съедает восклицательный знак в аргументах — путь вида B:\!1\src молча превращается в B:.
Настройка
| Что настроить | Как |
|---|---|
| Исключения по умолчанию | --list-default-excludes, затем --exclude или --no-default-excludes |
| Список файлов | --files-from или --git tracked |
| Порядок | --sort size — крупные первыми при бюджете |
| Бюджет | --token-budget и --budget-action |
| Пределы | --max-size 64K, чтобы один сгенерированный файл не съел окно |
| Заголовок документа | --title, --heading-level |
| Конфигурация | файл VAR=VALUE с ключами CTF_*, --print-config показывает итог |
Конфигурационный файл читается как данные и содержит только ключи CTF_* — то есть настройки нельзя «случайно» превратить в исполняемую команду. Для утилиты, работающей в чужих репозиториях, это правильное ограничение.
Коды выхода
| Код | Значение |
|---|---|
| 0 | успех |
| 1 | ошибка выполнения: ввод-вывод, права, неожиданное состояние |
| 2 | ошибка аргументов: неизвестная опция, неверное значение |
| 3 | ошибка обновления или сети |
| 4 | ничего не собрано и указан --strict |
Полезная деталь: --check-update использует код 3 для «есть новая версия», поэтому команда годится прямо как ворота в конвейере — без разбора текста.
Почему ручная склейка не работает
Соблазн простой: взять cat с длинным списком файлов и получить то же самое. На практике это разваливается в четырёх местах, и все четыре обнаруживаются уже после того, как документ ушёл в модель.
Первое: границы файлов теряются. Без заголовков и ограждений кода модель видит сплошной текст, где строка из одного файла продолжает строку другого. Ответы после этого содержат ссылки на несуществующие строки — и проверять их приходится вручную.
Второе: пути не восстанавливаются. cat не пишет, откуда взят кусок; если в проекте пять config.json в разных каталогах, восстановить соответствие невозможно. Относительный путь в заголовке — не украшение, а адрес, по которому модель может сослаться.
Третье: мусор не отсекается. Список, собранный через find . -name '*.js', включает node_modules целиком. Именно поэтому встроенные исключения — главная функция, а не мелочь.
Четвёртое: нет числа. После cat никто не знает, сколько файлов попало и сколько нет, и несоответствие обнаруживается по результату: модель отвечает про версию, которой в проекте нет. Итоговая таблица со статистикой закрывает именно эту дыру.
Отсюда и разница в подходе: утилита не «склеивает файлы», а строит документ по правилам, у которого есть оглавление, границы, адреса и отчёт.
Что показывает итоговая таблица
В конце документа печатается короткая сводка, и читать её полезнее, чем сам документ.
| Поле | О чём говорит |
|---|---|
| Candidates | сколько файлов нашлось до фильтрации |
| Collected | сколько попало в вывод |
| Skipped | сколько отсеяно всего |
| Skip reasons | поимённо: расширение, размер, глубина, симлинк, дубликат |
| Source bytes | суммарный объём исходников |
| Estimated tokens | оценка «байты / 4» |
| Truncated files | сколько файлов обрезано бюджетом |
| Budget dropped | сколько выброшено политикой drop |
| Duplicates | сколько одинаковых файлов схлопнуто |
Два поля стоит проверять всегда. Truncated files больше нуля означает, что часть кода в документе неполная: если модель будет отвечать по обрезанному файлу, ответ будет уверенным и неверным. Skip reasons показывает неожиданное: например, что треть файлов пропала из-за симлинков, о которых никто не помнил.
Отдельно про Candidates и Collected: их отношение — быстрый тест на слишком широкий фильтр. Если из сорока двух файлов отобрано четырнадцать по одному расширению, это нормально. Если из тысячи отобрано девятьсот, скорее всего в документ приехало то, что не нужно.
Как это ложится в конвейер
Утилита хорошо работает как шаг сборки, а не как ручная команда. Схема простая: прогон с --stats и --strict в проверке, затем прогон с записью файла.
Первый прогон отвечает на вопрос «сколько это стоит». Второй создаёт документ. Если между ними код изменился — документ устарел, и его надо пересобрать; именно поэтому --no-timestamp полезен: он позволяет побайтово сравнивать два прогона и видеть, изменилось ли что-то на самом деле, а не только отметка времени.
Для конвейера важны коды выхода. --strict превращает «ничего не собрано» в код 4, и это правильное поведение: пустой документ почти всегда означает ошибку в опциях, а не отсутствие файлов. Без --strict такая ошибка проходит молча и всплывает позже, когда модель отвечает «в проекте нет кода».
И последнее: документ для модели — это артефакт, а не мусор. Его стоит хранить рядом с коммитом, к которому он собран, чтобы через неделю можно было понять, на каком состоянии кода был получен ответ.
Подводные камни
- Оценка токенов — не измерение. «Байты / 4» завышает объём; на нестандартном тексте реальное число может отличаться в любую сторону.
--statsничего не пишет. Он печатает числа и выходит; файл при этом не создаётся — это не ошибка, а задумано.- Имена опций различаются между портами. В документации есть таблица соответствия bash и PowerShell; перенос скрипта без неё — источник ошибок.
- PowerShell предпочитает
.ps1. Если в каталоге лежат и.ps1, и.cmd, вызов может уйти не туда — используйте установленныйctf.cmd. cmd.exeи восклицательный знак. Отложенное раскрытие переменных удаляет!из аргументов; пути с таким символом требуют PowerShell.--strictменяет код выхода. В конвейере без него пустой результат выглядит успехом.--dedupтребуетsha256sum. Без него опция не сработает; на минимальных системах утилиты может не быть.- Симлинки не раскрываются. По умолчанию они считаются пропущенными, а каталоги-симлинки не обходятся — нужен
--follow. - Абсолютные пути по умолчанию не нужны.
--path-style absломает переносимость документа: модель увидит пути машины, а не проекта. - Исключения по умолчанию можно потерять.
--no-default-excludesвыключает их целиком, и в документ приедетnode_modules. - Обрезка по бюджету помечается комментарием. Файл в выводе будет неполным — это видно, но легко пропустить при чтении.
Что даёт раздел о сбоях
В AGENTS.md есть таблица «симптом → причина → действие», и это самая практичная часть документации. Три строки из неё стоят отдельного упоминания, потому что каждая экономит час диагностики.
Первая: --version печатает не версию, а запускает сборку и создаёт файл all---version-files.md. Причина не в утилите, а в том, как PowerShell разбирает аргументы: движок ctf.ps1 попал в PATH напрямую, и длинная опция привязалась к позиционному параметру. Лечение — переустановить и вызывать bin\ctf.cmd.
Вторая: -V на Windows печатает отладочную информацию, а --verbose не делает ничего. Здесь путаница не в утилите, а в соглашениях PowerShell: -V в порте означает --verbose, а --verbose перехватывается общим параметром -Verbose и молча игнорируется. Для версии нужен --version или -v.
Третья: make install падает с «Permission denied: ./install.sh». Причина — файлы закоммичены без исполняемого бита (режим 100644), и это открытая находка в журнале изменений 4.1.0. Правильное действие — запустить через bash ./install.sh, а не менять режимы в общем клоне.
Общая мысль: почти все «странные» ошибки Windows-порта объясняются тем, как PowerShell обрабатывает аргументы, а не логикой утилиты. Поэтому установщик и ставит на PATH ровно один файл — обёртку.
Чек-лист
- [ ] Установить и проверить
ctf --version. - [ ] Посмотреть исключения по умолчанию:
--list-default-excludes. - [ ] Сделать
--dry-runпо выбранным расширениям и прочитать список. - [ ] Оценить объём:
--statsс нужным--token-budget. - [ ] Выбрать стратегию при нехватке бюджета: обрезать или выбрасывать.
- [ ] Собрать документ с
--tocи--metadata. - [ ] Проверить, что пути относительные, а не абсолютные.
- [ ] Для повторяемости добавить
--no-timestampи хранить вывод в репозитории. - [ ] Для конвейера включить
--strict, чтобы пустой результат не считался успехом. - [ ] Проверить итоговую таблицу: сколько пропущено и почему.
Где утилита не нужна
Честная граница полезна не меньше списка достоинств.
Не нужна, когда проект — один файл. Обойти дерево, отфильтровать и собрать документ из трёхсот строк — это больше движений, чем открыть файл.
Не нужна, когда нужен не текст, а структура. Если задача — «где определена функция и кто её вызывает», склейка не поможет; тут нужен индекс кода, а не документ.
Не нужна, когда проект не влезает в контекст ни при какой стратегии. drop и truncate дадут частичный документ, и модель будет уверенно отвечать по фрагментам. В таком случае честнее выбрать подмножество осознанно — по каталогам или по расширениям, — а не отдавать решение бюджету.
Не нужна, когда важна приватность. Всё, что попало в документ, уходит туда, куда его отправили: конфигурации, строки подключения, тестовые данные с реальными адресами. Утилита не вычищает секреты и не обещает этого; фильтры по расширениям и путям — единственный механизм ограничения.
И последнее: она не заменяет чтение кода человеком. Документ помогает модели, но решение о том, что в проекте важно, остаётся за тем, кто его читает.
FAQ
Чем это лучше обычного cat по списку файлов?
Отбором, бюджетом и структурой: исключения по умолчанию, оглавление, метаданные, ограничение объёма и отчёт о пропущенных.
Считает ли утилита токены точно?
Нет. Оценка — «байты / 4», консервативная для кода. Для точного подсчёта нужен токенизатор конкретной модели.
Что будет, если файл не влезает в бюджет?
По умолчанию он обрезается по границе строки с пометкой; с --budget-action drop выбрасывается целиком и попадает в статистику.
Можно ли собрать только файлы из git?
Да: --git tracked перечисляет отслеживаемые, --git all добавляет неотслеживаемые с учётом .gitignore.
Работает ли на Windows без WSL?
Да, есть ctf.ps1 и ctf.bat. Установщик создаёт ctf.cmd, который вызывает движок через PowerShell — так обходятся две описанные ловушки.
Зачем --no-timestamp?
Чтобы два прогона по одному дереву давали побайтово одинаковый файл: его можно сравнивать, хранить в репозитории и добавлять в контроль версий.
Что было в документации продукта и что добавилось здесь
Исходный материал — README на 677 строк с пятнадцатью разделами и подробным справочником опций. Как справочник он хорош: все флаги, все коды выхода, все форматы. Как знакомство — тяжеловат: читатель узнаёт, что можно настроить, но не сразу понимает, что стоит настраивать.
| Было | Стало |
|---|---|
| справочник опций подряд | группировка по задаче: отбор, формат, бюджет |
нет объяснения, почему не cat |
отдельный разбор четырёх мест, где ручная склейка ломается |
| статистика описана как список полей | сказано, какие два поля проверять всегда и почему |
| ловушки Windows только в разделе про Windows | вынесены в подводные камни вместе с остальными |
Проверки добавили то, чего в README нет по определению: результат на двух платформах и числа из прогона. Совпадающая структура вывода на Windows и Linux — факт, а не обещание; 42 кандидата и 14 отобранных по одному расширению — тоже факт, его можно перепроверить одной командой.
Чего в статье нет и почему: точности оценки токенов. Утилита считает «байты / 4» и не претендует на большее. Писать «влезет в контекст» без токенизатора конкретной модели было бы неправдой, поэтому в тексте прямо сказано, что это оценка.
Итог
ctf-collect-to-file 4.1.0 делает одну вещь и делает её предсказуемо: отбирает файлы, укладывает их в бюджет и собирает документ со структурой. Прогоны подтвердили одинаковое поведение на Windows и Linux, корректную статистику и работающий --dry-run. Ограничения честные: оценка токенов приблизительная, --stats не пишет файл, а на Windows есть две задокументированные ловушки, ради которых и появился отдельный установщик.
Цитата: Контекст модели — как чемодан: ценность не в том, сколько влезло, а в том, что не пришлось выкладывать на месте.
Связанные материалы
- github-wiki-llm-writer: вики репозитория с проверкой фактов — другой инструмент той же природы: собрать знание о репозитории.
- RAGRAF 0.11.0: контракт-пин и пробы поведения — индексация кода вместо склейки файлов.
- Bash WP-CLI Update: обслуживание парка WordPress — bash-утилита с контрактом кодов выхода.
- CF7 Spam Checker Pro: защита формы — пример проекта, который удобно подавать модели одним документом.
- Релиз v4.1.0 — заметки и дерево исходников.
LLM Summary
- Тема:
ctf-collect-to-file4.1.0 — bash-утилита, собирающая дерево исходников в один документ для контекста модели. - Форматы: Markdown (по умолчанию), JSON, JSONL, текст; оглавление, метаданные на файл, нумерация строк, относительные пути.
- Отбор:
-e/--ext,-E/--exclude,-I/--include,--exclude-dir,--max-depth,--max-size,--min-size,--files-from,--git tracked|all; встроенные исключения VCS, зависимостей и сборки. - Бюджет:
--token-budgetс оценкой «байты / 4», действиеtruncate(по умолчанию) илиdrop;--truncate-lines,--max-sizeкак дополнительные пределы. - Коды выхода: 0 успех, 1 ошибка выполнения, 2 ошибка аргументов, 3 обновление или сеть, 4 ничего не собрано при
--strict. - Проверено 12.11.2026: архив v4.1.0 — 147 375 байт, SHA-256
ff13457d…37b8a34, 42 файла;ctf v4.1.0на Windows (Git Bash) и на Linux (bs535); сборка трёх файлов — собрано 2, пропущено 1, вывод 754 байта локально и 606 байт на сервере; JSON — 219 байт с полемfiles;--dry-runвыдаёт TSV; по собственному репозиторию 42 кандидата и 14 отобрано по-e sh, крупнейший файлctf.sh— 99 523 байта и 2 222 строки. - Ловушки Windows: PowerShell предпочитает
.ps1файлу.cmdи привязывает--versionк позиционному аргументу; отложенное раскрытие вcmd.exeудаляет!из путей — обходятся установщиком с однимctf.cmdчерезpwsh -File. - Чего нет: точного подсчёта токенов; оценка консервативная и приблизительная.
- Не проверялось: поведение на очень больших деревьях и точность оценки на реальных токенизаторах.
- Ссылки: https://github.com/paulmann/ctf-collect-to-file, https://github.com/paulmann/ctf-collect-to-file/releases/tag/v4.1.0
Промт для агента (установка и настройка)
Готовый промт: скопируйте блок целиком. Источник шагов — AGENTS.md репозитория (в ветке main он есть, 15 420 байт; в архив тега v4.1.0 не попал, добавлен позже), сверено с SKILL.md, README.md и прогонами на Windows и Linux.
Задача: поставить ctf-collect-to-file и собрать контекстный документ по нужному дереву, уложившись в бюджет токенов.

Материалы:
- репозиторий: https://github.com/paulmann/ctf-collect-to-file
- SKILL.md: https://github.com/paulmann/ctf-collect-to-file/blob/main/SKILL.md
- README: https://github.com/paulmann/ctf-collect-to-file/blob/main/README.md
- AGENTS.md: https://github.com/paulmann/ctf-collect-to-file/blob/main/AGENTS.md (в тег v4.1.0 не входит, проверено 12.11.2026)
- SKILL.md: https://github.com/paulmann/ctf-collect-to-file/blob/main/SKILL.md
- релиз: https://github.com/paulmann/ctf-collect-to-file/releases/tag/v4.1.0

Шаг 1. Установить: bash ./install.sh --prefix "$HOME/.local" (Linux/macOS; через bash, потому что исполняемого бита в репозитории нет) или pwsh -NoLogo -NoProfile -NonInteractive -File .\install-ctf.ps1 (Windows), затем ctf --version — ожидается ctf v4.1.0.
Шаг 2. Посмотреть встроенные исключения: ctf --list-default-excludes.
Шаг 3. Пробный прогон без записи: ctf -e <расширения> -n <каталог> — проверить список.
Шаг 4. Оценить объём: ctf -e <расширения> --stats --token-budget <N> <каталог>.
Шаг 5. Выбрать стратегию: --budget-action truncate или drop.
Шаг 6. Собрать документ: ctf -e <расширения> --token-budget <N> --toc --metadata <каталог> out.md
Шаг 7. Проверить: пути относительные, оглавление на месте, в итоговой таблице число пропущенных объяснено.
Шаг 8. Для повторяемости добавить --no-timestamp и --dedup.
Шаг 9. Для конвейера добавить --strict, чтобы пустой результат давал код 4.

Запрещено:
- отключать исключения по умолчанию (--no-default-excludes) без понимания, что попадёт в документ;
- считать оценку токенов точной: это ceil(байты/4);
- ждать файл после --stats: команда печатает числа и выходит;
- использовать cmd.exe для путей с символом ! ;
- вызывать ctf.ps1 напрямую: PowerShell привязывает --long-option к позиционному аргументу, и ctf --version запускает сборку вместо печати версии;
- запускать --update без присмотра: это единственная самописменная операция, только вручную;
- публиковать собранный документ с абсолютными путями и секретами из конфигураций.

Что считать успехом: ctf --version отдаёт 4.1.0, dry-run показывает ожидаемый список, документ собран с оглавлением, пути относительные, итоговая таблица объясняет пропуски, повторный прогон с --no-timestamp даёт идентичный файл.