Этот обзор AI-агентов собран не по пресс-релизам: лицензии, последние релизы и статус шестнадцати публичных проектов сняты 26 октября 2026 года через GitHub API и npm-реестр, два проекта автора проверены по локальным репозиториям, а числа о собственном индексе — из вывода RAGRAF 0.3.1 на рабочей машине. Главная мысль неприятна для жанра «рейтинг платформ»: сравнивать в одном столбце runtime, фреймворк оркестрации и базу знаний о коде — категориальная ошибка, потому что это три разных слоя одного стека, и они решают разные задачи. Ниже — разбор этих слоёв, проверенная таблица платформ без маркетинговых формулировок, измеренные задержки и порядок сборки локального контура, в котором агент отвечает фактами со ссылкой файл:строка, а не догадками.

TL;DR: что это и как выбрать за десять минут
- Сравнивать по одному баллу нельзя. Runtime (
AutoClaw,OpenCode,Claude Code), оркестратор (LangGraph,CrewAI) и слой знаний (RAGRAF) — разные слои: они не заменяют друг друга, а собираются в стек. - Лицензия решает больше, чем набор функций. Из шестнадцати публичных проектов двенадцать — под OSI-лицензиями (MIT, Apache-2.0, AGPL-3.0), три — source-available:
n8nпод Sustainable Use License,Dify— под собственной лицензией с запретом multi-tenant SaaS,AutoGPT— под PolyForm Shield;Claude Code— проприетарный продукт. - Два самых частых заблуждения опровергнуты замером: в maintenance mode находится
microsoft/autogen(последний релиз 30.09.2025), а не форкAG2(релиз 1.2.1 от 21.10.2026);Microsoft Agent Framework— не preview, а версия 1.0 для .NET и Python (в preview только Go). - Проверка за десять минут:
git cloneрепозитория,pip install -e .(илиscripts/install.ps1на Windows), затемragraf init,ragraf register,ragraf indexиragraf query symbol <имя>— если в ответе есть ревизия и диапазон строк, слой знаний работает. - Главное ограничение слоя знаний: индекс отвечает только о том, что попало в корпус. Символы из внешних библиотек приходят без адреса — это видно прямо в ответе, и это правильнее, чем выдуманная строка.
- Экономика внимания: 59 инструментов MCP в контексте агента — это не «богатство возможностей», а расход токенов; инструменты подключаются выборочно, как и файлы.
Проблема, которую это решает
Агент без отдельного слоя знаний ищет по репозиторию текстом: grep, чтение целых файлов, догадки по именам. На корпусе из 861 файла это даёт десятки тысяч строк контекста на один вопрос. Когда такой агент говорит «функция вызывается только здесь», проверить это нечем: в ответе нет ни файла, ни строки, ни ревизии, по которой он смотрел. Ошибка обнаруживается на ревью, то есть уже после правки.
Второй источник ошибок — сам индекс, если не понимать, что в нём лежит. В собственном корпусе RAGRAF на 26.10.2026: 66 875 рёбер графа, из них 16 552 объявлены в коде (stated), а 48 617 выведены по совпадению имён (derived) — 73 % связей. Выведенная связь не факт: одноимённый метод в другом классе даёт ложное ребро. Хороший инструмент отдаёт эти категории раздельно, и первое, что нужно проверить в любом «графе кода», — умеет ли он различать объявленное и выведенное.
Третья проблема — жанровая. Обзоры платформ 2026 года грешат тремя вещами: смешивают классы продуктов в одной таблице; читают лицензию по обложке (так n8n превращается в «open source», хотя это fair-code); и повторяют устаревшие статусы. Проверка 26.10.2026 показала, что LangGraph Platform больше не называется так с октября 2025 года (теперь LangSmith Deployment), репозиторий OpenCode живёт в организации anomalyco, а не sst, а Microsoft Agent Framework вышел в 1.0 в апреле 2026. Ни одно из этих изменений не видно, если читать обзоры, а не страницы релизов.
Что такое агентная платформа: три слоя, которые постоянно путают
Агентный стек делится на три слоя, и у каждого свой предмет ответственности. Runtime (его же называют harness) — среда, где модель получает инструменты и выполняет шаги: файловая система, shell, браузер, планировщик, права. Оркестратор — фреймворк, которым разработчик описывает граф шагов, состояние, ветвления и восстановление после сбоя. Слой знаний — то, что превращает вопрос агента в проверяемый факт о коде, документации или схеме базы.
flowchart TB
  subgraph RT["Слой 1. Runtime, он же harness"]
    A1["AutoClaw · OpenCode · Claude Code
Codex CLI · DeepSeek Harness"]
  end
  subgraph OR["Слой 2. Оркестрация"]
    B1["LangGraph · CrewAI · AG2
Microsoft Agent Framework"]
  end
  subgraph KN["Слой 3. Знания о коде"]
    C1["RAGRAF: BM25 + векторы + граф
ответ со ссылкой file:line"]
  end
  RT -->|"вызывает инструменты"| OR
  OR -->|"задаёт вопросы"| KN
KN -.->|"конверт: ревизия, происхождение, границы"| RT| Слой | На какой вопрос отвечает | Кто здесь | Что придётся дать самому |
|---|---|---|---|
| Runtime / harness | «Кто выполняет действия и с какими правами?» | AutoClaw, OpenCode, Claude Code, Codex CLI, DeepSeek Harness, OpenClaw, Hermes, Agent Zero |
Изоляция, лимиты прав, отдельные учётные записи |
| Оркестрация | «В каком порядке идти и что делать при сбое?» | LangGraph, CrewAI, AG2, Microsoft Agent Framework, AutoGen |
Код графа, состояние, тесты переходов |
| Знания о коде | «Где это объявлено и что сломается при правке?» | RAGRAF, частично встроенные индексы IDE |
Индексация корпуса и её свежесть |
| Low-code автоматизация | «Как связать агента с сервисами без кода?» | n8n, Dify, AutoGPT |
Политика данных, права интеграций |
| Персональный поиск | «Что я уже знаю по этому вопросу?» | Khoj, Hermes (как память) |
Политика хранения личных данных |
Практический вывод из таблицы: вопрос «какая платформа лучше» не имеет ответа, пока не назван слой. Runtime выбирают по правам и каналам, оркестратор — по требованиям к состоянию и восстановлению, слой знаний — по языкам, свежести и проверяемости ответа.
Возможности: шесть классов решений и что каждый реально даёт
Классы различаются не «мощностью», а тем, что вам придётся написать самому. Ниже — карта классов с честной колонкой «чего не даёт».
| Класс | Ядро возможностей | Чего не даёт |
|---|---|---|
| Runtime / harness | Инструменты (файлы, shell, браузер), планирование шагов, сессии, навыки, MCP-подключения | Гарантий процесса: изоляция и лимиты прав настраиваются вручную |
| Фреймворк оркестрации | Граф шагов, состояние, checkpointing, human-in-the-loop, воспроизводимость | Готового интерфейса и агента «из коробки»: нужен свой код |
| Слой знаний о коде | Граф и векторы по репозиторию, адреса файл:строка, свежесть, схема БД из миграций |
Понимания замысла: индекс знает структуру, не смысл задачи |
| Low-code платформа | Визуальный конструктор, интеграции, RAG-пайплайны, публикация API | Тонкого контроля над состоянием и обработкой сбоев |
| Автономный агент | Готовая среда в контейнере, свои инструменты, длинные задачи | Промышленного SLA и предсказуемой стоимости прогона |
| Персональный ассистент | Память, поиск по личным данным, каналы мессенджеров | Работы с большим кодом и оркестрации процессов |
Отдельно стоит сказать про MCP — протокол, через который runtime получает инструменты. Именно он сделал слои стыкуемыми: один и тот же сервер знаний подключается к AutoClaw, SagaAI, DeepSeek Harness и любому другому runtime без переписывания. Но у протокола есть цена: количество инструментов попадает в контекст модели. Пятьдесят девять инструментов — это заметная часть бюджета токенов до начала работы, поэтому подключать всё подряд нерационально; в одной из статей цикла мы разбирали, как этот бюджет расходуется.
Каталог платформ: проверенные лицензии, релизы и статусы
Все данные в таблице сняты 26.10.2026 через GitHub API (/repos и /releases/latest) и npm-реестр. Звёзды — снимок на ту же дату, они показывают масштаб внимания, а не качество. «Релиз» — самый свежий опубликованный тег. Записи в таблице идут по убыванию звёзд, а не по «силе» — сила зависит от слоя задачи.
| Платформа | Класс | Лицензия | Релиз на 26.10.2026 | Запуск | ★ |
|---|---|---|---|---|---|
| OpenClaw | Gateway к мессенджерам | MIT | v2026.10.7 (24.10.2026) | self-hosted, Node 24+ | 393 145 |
| DeepSeek Harness | Harness, plugin-kernel | MIT | dsh-v0.2.1-rc.3 (23.10.2026) | npx @deepseek-ai/dsh |
262 488 |
| Hermes (Nous Research) | Персональный агент с памятью | MIT | v0.22.5 (23.10.2026) | self-hosted, CLI + шлюз | 257 360 |
| OpenCode | Coding-агент | MIT | v1.19.4 (22.10.2026) | TUI, desktop, IDE | 221 901 |
| n8n | Low-code автоматизация | Sustainable Use (fair-code) | n8n@2.44.7 (26.10.2026) | Docker, npm, Cloud | 208 661 |
| AutoGPT | Low-code платформа | PolyForm Shield 1.0.0 + MIT | autogpt-platform-beta-v0.9.0 (23.10.2026) | Docker, облако | 187 776 |
| Dify | Low-code LLM-платформа | Dify Open Source License | 1.18.0 (23.10.2026) | Docker Compose, Cloud | 159 620 |
| Claude Code | Coding-агент | Проприетарная, Commercial Terms | v2.1.310 (23.10.2026) | npm, нативный установщик | 153 461 |
| Codex CLI | Coding-агент | Apache-2.0 | rust-v0.164.0 (23.10.2026) | npm @openai/codex |
131 021 |
| AutoGen (Microsoft) | Фреймворк | MIT (код), maintenance mode | python-v0.7.5 (30.09.2025) | self-hosted библиотека | 61 574 |
| CrewAI | Фреймворк оркестрации | MIT | 1.15.30 (24.10.2026) | pip, CrewAI AMP | 60 131 |
| LangGraph | Фреймворк оркестрации | MIT | cli 0.4.40 (26.10.2026) | pip, LangSmith Deployment | 43 936 |
| Khoj | Персональный поиск | AGPL-3.0 | 2.0.0-beta.28 (26.03.2026) | self-hosted; облако закрыто 15.04.2026 | 37 841 |
| Agent Zero | Автономный агент | MIT (по файлу LICENSE) | v2.14 (13.10.2026) | Docker | 19 573 |
| Microsoft Agent Framework | Фреймворк оркестрации | MIT | dotnet-1.26.0 (23.10.2026) | .NET и Python (Go — preview) | 14 328 |
| AG2 | Фреймворк (форк AutoGen) | Apache-2.0 | v1.2.1 (21.10.2026) | pip ag2 |
5 020 |
Плюс два проекта, которые не участвуют в общем рейтинге по способу поставки и потому идут отдельной строкой: SagaAI — self-hosted платформа команды ИИ-сотрудников под PolyForm Noncommercial 1.0.0 (Streamlit, Python 3.12+, порт 8501) — и RAGRAF 0.3.1 под BUSL-1.1, слой знаний о коде, о котором дальше будет больше всего чисел. Вместе с этими двумя в рейтинге ниже — 18 решений.
Шесть лидеров: что именно они дают
LangGraph: контроль вместо надежды
LangGraph — низкоуровневый оркестратор: граф узлов и рёбер, типизированное состояние, checkpointing, durable execution, human-in-the-loop, streaming (лицензия MIT, релиз cli 0.4.40 от 26.10.2026). За наблюдаемость отвечает отдельный продукт LangSmith, и это важно для бюджета: трассировка не входит в библиотеку. Прежнее название управляемого рантайма — LangGraph Platform — с октября 2025 года не используется, теперь это LangSmith Deployment; статьи, где написано иначе, устарели. Цена гибкости — ручное описание переходов: готовых ролей и задач здесь нет.
OpenCode: открытый coding-агент с двумя режимами
OpenCode — терминальный агент (плюс десктоп и расширение IDE), собранный вокруг общей фоновой службы; в нём два встроенных агента: build с полным доступом и plan только на чтение. Лицензия MIT относится к открытой сборке, облачный контур регулируется отдельным договором — двухконтурная модель, а не противоречие. Репозиторий сменил владельца: актуальный адрес — anomalyco/opencode, юрлицо ANOMALY INNOVATIONS, INC. Утверждение «у OpenCode 75+ провайдеров» встречается в обзорах, но официальной страницей не подтверждено — в таблицу выше оно не попало намеренно.
CrewAI: роли, задачи, Flows
CrewAI — MIT-фреймворк для ролевой мультиагентности: Crews (агенты с ролями и задачами) и Flows (детерминированная оркестрация поверх событий), плюс guardrails, память и наблюдаемость, заявленные как встроенные. Промышленные вещи — RBAC, аудит, управляемый рантайм — относятся к коммерческому CrewAI AMP, а не к MIT-ядру. Это нормальная модель монетизации, но её надо знать заранее: «поставим CrewAI и получим корпоративный контроль» не работает без платной части.
AutoClaw: runtime для смешанных задач
AutoClaw (Z.ai) — десктопное приложение-агент, проприетарное, с двумя заявленными механиками: Goal Mode (задаётся результат и критерии приёмки, агент ведёт план) и Agent Cluster (одна задача делится между несколькими агентами). Заявлено 50+ встроенных навыков. Два факта, которые стоит держать в голове: официальный changelog на 26.10.2026 заканчивается веткой 1.17.x (август 2026) — обозначение «AutoClaw 2» встречается только в сторонних репозиториях и багрепортах; и условия использования прямо рекомендуют запускать продукт в виртуальной машине или песочнице, потому что ему нужны повышенные локальные привилегии. Второе — не недостаток, а честное предупреждение, которого у большинства конкурентов нет.
DeepSeek Harness: всё есть плагин
DeepSeek Harness (dsh) — MIT-харнесс от DeepSeek AI поверх мета-фреймворка Cordis: модель, инструменты, команды, маршруты и веб-клиент подключаются как плагины, профили собираются из одного ядра. Журнал сессии пишется только на дозапись, отсюда resume, fork и replay по одному и тому же потоку событий — это сильная сторона для разбора инцидентов. Установка проверена по npm: пакет @deepseek-ai/dsh версии 0.2.1-rc.2, то есть линия ещё в предрелизе; интерфейс команд — dsh с профилями и управлением плагинами. Вокруг проекта много сайтов-двойников: официальными считаются только домены DeepSeek и организация deepseek-ai.
RAGRAF: слой знаний, который умеет отказываться
RAGRAF — не агент и не платформа, а knowledge-слой: индексирует репозиторий в каталог .ragraf и отвечает агенту через MCP фиксированными операциями — где объявлен символ, кто его вызывает, что затронет правка, что в таблице базы. Лицензия BUSL-1.1, версия 0.3.1: 59 инструментов MCP, 52 операции фасада, 50 операций CLI, разбор деревом для 29 языков, граф узлов и рёбер для 16. Ключевое свойство — каждый ответ несёт ревизию, происхождение (index, live, computed), границы применимости и признак устаревания, а чего инструмент не знает, он говорит прямо.
Рейтинг: редакционная оценка и почему баллы нельзя складывать
Ниже — та же оценка по шести критериям (функциональность, расширяемость, готовность к эксплуатации, простота внедрения, стоимость, экосистема), что и в первой версии этого обзора, с исправленными фактами. Это редакционное мнение о зрелости на 26.10.2026, а не benchmark: баллы получены разбором документации и релизов, а не прогоном одинаковых задач. Сравнивать напрямую оркестратор и слой знаний по такой шкале некорректно — поэтому в таблице указан слой.
| Место | Платформа | Слой | Балл | За счёт чего |
|---|---|---|---|---|
| 1 | LangGraph | оркестрация | 27/30 | Состояние, checkpointing, восстановление, воспроизводимость |
| 2 | OpenCode | runtime | 25/30 | Открытый код, локальные модели, режим только на чтение |
| 3 | CrewAI | оркестрация | 24/30 | Быстрый старт, роли, Flows |
| 4 | AutoClaw | runtime | 24/30 | Goal Mode, несколько агентов на задачу, навыки |
| 5 | DeepSeek Harness | runtime | 23/30 | Плагинное ядро, журнал с replay и fork |
| 6 | OpenClaw | runtime | 23/30 | Шлюз к мессенджерам, MIT, своя машина |
| 7 | SagaAI | платформа | 23/30 | Роли сотрудников, RAG, DevAgent с откатом |
| 8 | RAGRAF | знания | 22/30 | Проверяемые факты файл:строка, свежесть, MCP |
| 9 | AG2 | оркестрация | 22/30 | Разговорные паттерны, Apache-2.0, живой форк |
| 10 | Microsoft Agent Framework | оркестрация | 21/30 | 1.0 для .NET и Python, MCP и A2A, Azure |
| 11 | Hermes | runtime | 21/30 | Память и самообучение, 27+ платформ в документации |
| 12 | Claude Code | runtime | 21/30 | Сильный coding-профиль, встроенный sandbox |
| 13 | Codex CLI | runtime | 20/30 | Локальный запуск, песочница на уровне ОС, Apache-2.0 |
| 14 | n8n | low-code | 20/30 | 400+ интеграций, визуальные workflow |
| 15 | Dify | low-code | 19/30 | Конструктор агентных workflow и RAG-пайплайнов |
| 16 | Agent Zero | runtime | 18/30 | Docker-окружение, браузер с аннотацией DOM |
| 17 | Khoj | персональный поиск | 16/30 | Поиск по личным данным, свои агенты |
| 18 | AutoGPT | low-code | 14/30 | Визуальный конструктор, marketplace; платформа в beta |
Три строки этой таблицы изменились против первой версии обзора по фактам, а не по вкусу: Microsoft Agent Framework поднялся, потому что 1.0 вышла в апреле 2026 и это уже не preview; AG2 отделён от AutoGen, потому что заморожен именно microsoft/autogen, а форк выпускает 1.2.x; AutoGen из общего рейтинга убран в таблицу каталога как проект в режиме поддержки.
Как это устроено внутри: путь от вопроса до проверяемого факта
Слой знаний работает не как поиск, а как фиксированный набор операций с обязательным конвертом ответа. Агент не «спрашивает текстом», а называет операцию: symbol, callers, impact, write_check, db_table. Дальше фасад выбирает источник — граф, полнотекстовый индекс BM25, векторы или живую схему базы — и собирает ответ.
flowchart LR
  Q["Вопрос агента"] --> M["MCP stdio
59 инструментов"]
  M --> F["Фасад
52 операции"]
  F --> D{"Что известно
о символе"}
  D -->|"объявлен в коде"| G["Узлы и рёбра stated
16 552"]
  D -->|"выведено по имени"| H["Рёбра derived
48 617"]
  D -->|"нет в корпусе"| X["external
адрес неизвестен"]
  G --> E["Конверт ответа"]
  H --> E
  X --> E
  E --> V{"Факт проверяем"}
  V -->|"да"| OK["Агент правит код"]
  V -->|"нет"| NO["Агент читает файл сам"]
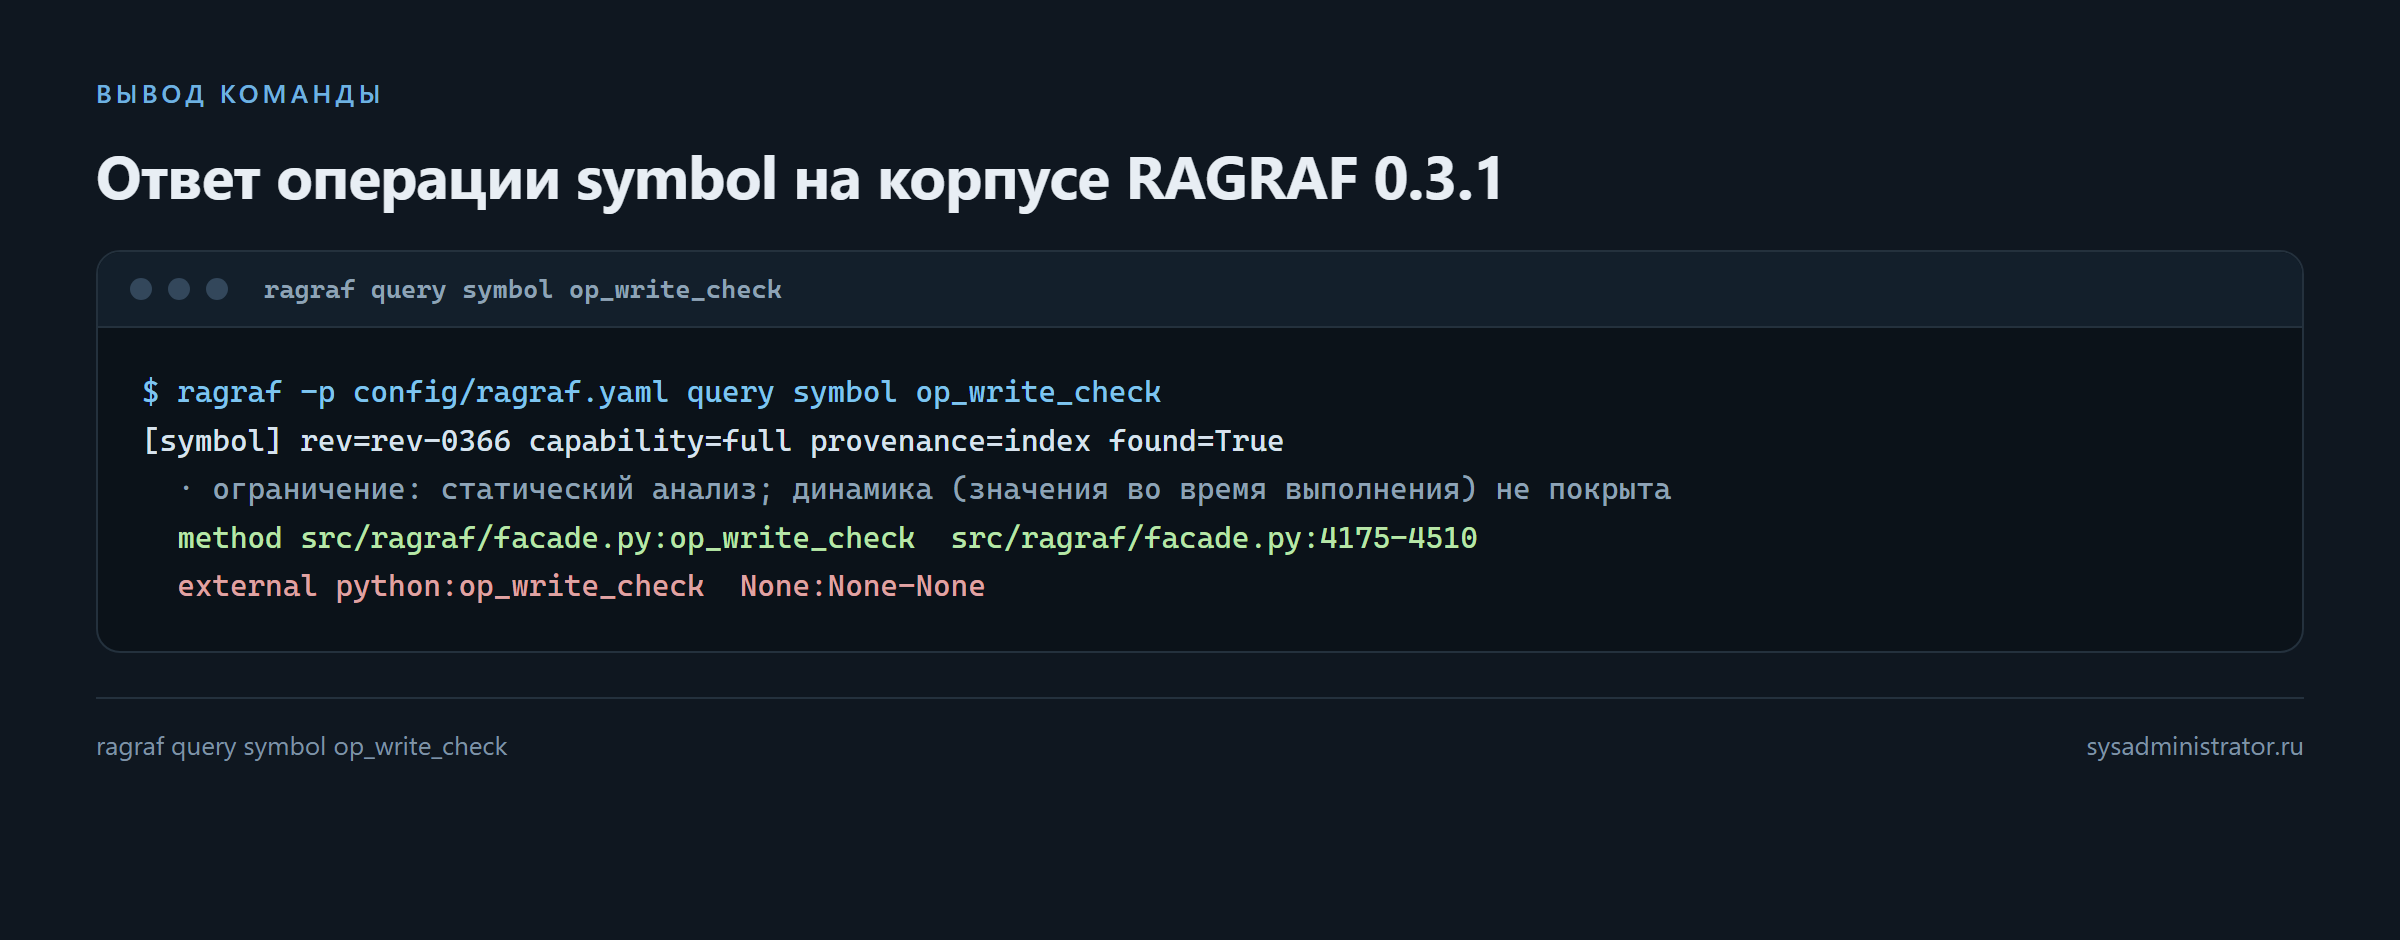
Вот настоящий обмен, снятый на корпусе RAGRAF 0.3.1: запрос одной строкой и ответ целиком, без сокращений.
$ ragraf -p config/ragraf.yaml query symbol op_write_check
[symbol] rev=rev-0366 capability=full provenance=index found=True
  · ограничение: статический анализ; динамика (значения во время выполнения) не покрыта
  method src/ragraf/facade.py:op_write_check  src/ragraf/facade.py:4175-4510
  external python:op_write_check  None:None-None
Читать этот ответ нужно правильно, и это главный навык работы с такими инструментами. Первая строка говорит, по какой ревизии смотрели и насколько полон индекс (capability=full). Вторая — граница применимости: статический анализ не знает значений во время выполнения, и это ограничение самого метода, а не сбой. Третья строка — факт со ссылкой: метод объявлен в файле facade.py, строки 4175–4510. Четвёртая — честный отказ: внешний символ с тем же именем есть, но его адрес неизвестен, поэтому в полях стоят None. Слабое место превращено в видимую метку, а не в правдоподобную выдумку.
Замеры и цифры
Все числа ниже сняты 26.10.2026 на одной рабочей машине (Windows, Python 3.13, корпус RAGRAF 861 файл). Это замеры одного контура, а не сравнение платформ: переносить их на другой корпус и другое железо нельзя, порядок величин — можно.
| Что измерено | Значение | Способ снятия |
|---|---|---|
| Инструментов MCP | 59 | интроспекция пакета 0.3.1 |
| Операций фасада / CLI | 52 / 50 | подсчёт методов op_* и реестра CLI |
| Языков разбора деревом / с графом | 29 / 16 | конфигурация языков пакета |
| Файлов, узлов, рёбер в корпусе | 861 / 5 122 / 66 875 | query index_status |
| Рёбер объявленных / выведенных | 16 552 / 48 617 | то же, поля edges_stated и edges_derived |
| Символов и чанков | 18 383 / 4 736 | то же |
| Размер чанка: средний / максимум | 415 / 4 914 токенов | то же, при лимите 8 000, сверх лимита 0 |
| Стадии индексации | скан 1,17 с · AST 4,38 с · загрузка 1,61 с · векторы 8,15 с | журнал прогонов индексатора |
Задержка symbol / callers / search |
0,65 с / 0,76 с / 2,9 с | медиана 5, 3 и 3 прогонов, каждый — новый процесс |

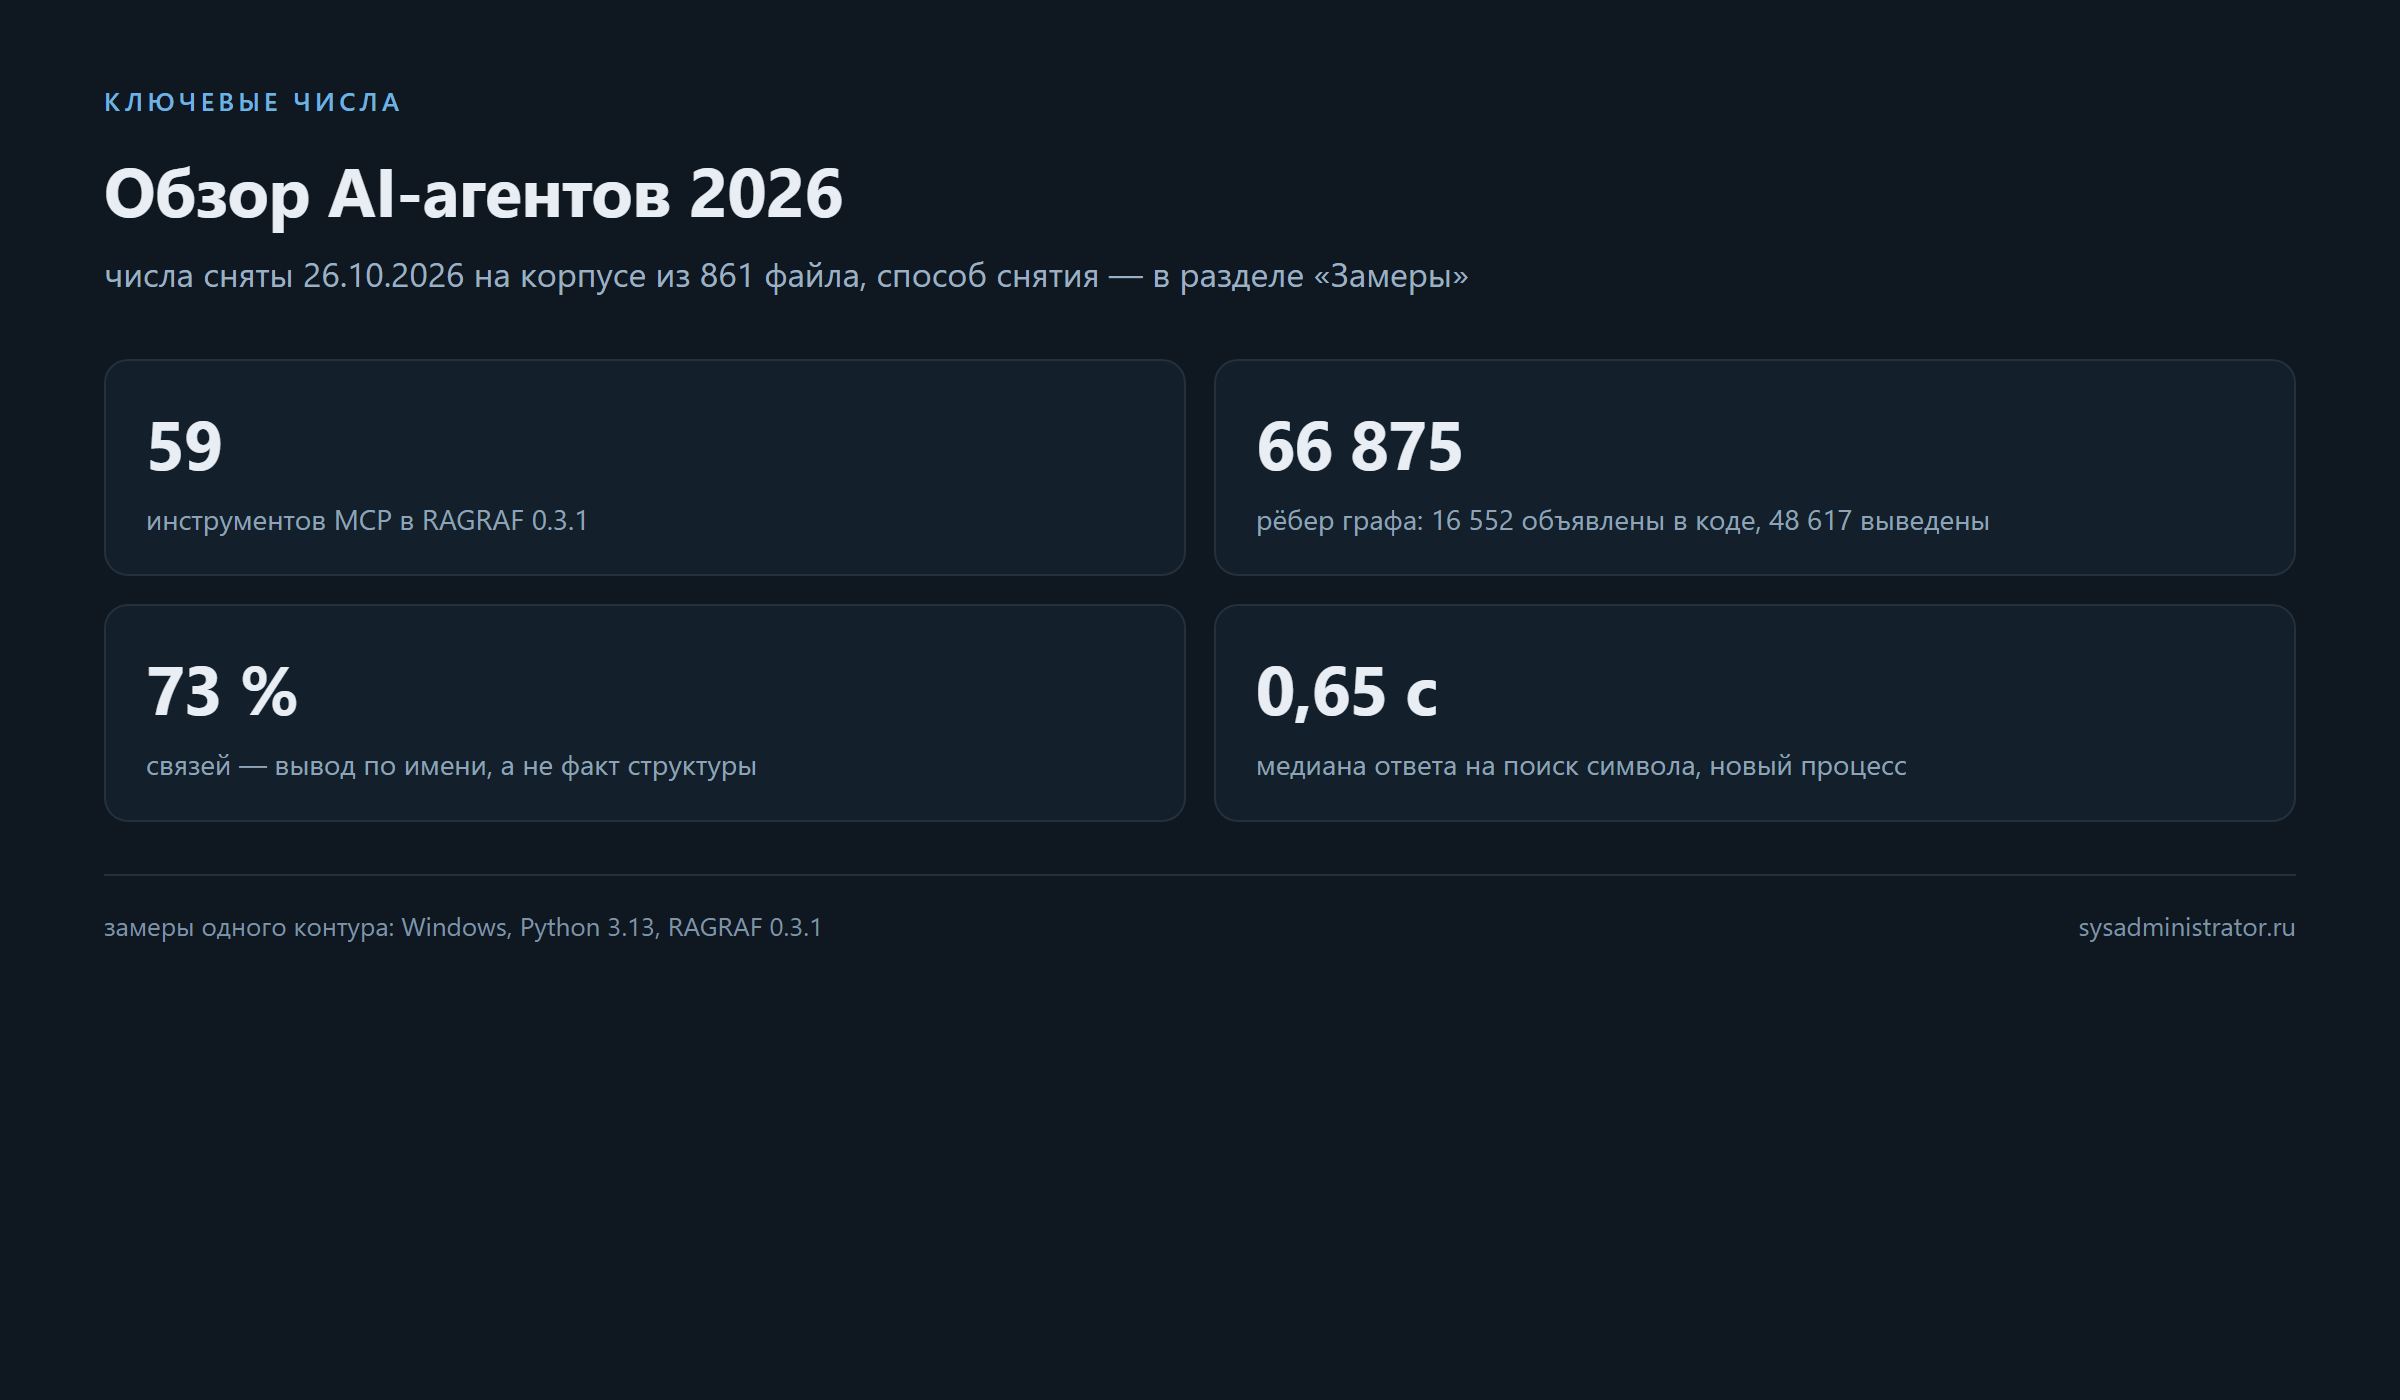
Оговорка про задержки, без которой числа бесполезны: каждый вызов CLI — отдельный процесс, поэтому в 0,65 с входит запуск Python и чтение индекса, а в 2,9 с поиска — ещё и загрузка модели векторов. Внутри MCP-сервера процесс живёт постоянно, модель загружается один раз, и те же операции укладываются в десятки миллисекунд. Сравнивать «CLI против CLI» и «сервер против сервера» нужно раздельно — иначе получится, что инструмент медленный, хотя медленный запуск.
Почему это круто
- Ответ можно проверить, не спрашивая автора. В каждом ответе есть ревизия, источник (
provenance) и диапазон строк — три вещи, которых нет ни уgrep, ни у векторного поиска по документации. - Слои стыкуются через MCP. Один сервер знаний обслуживает
AutoClaw,SagaAI,DeepSeek Harnessи любой runtime с поддержкой протокола: смена агента не требует переиндексации. - Инструмент умеет отказываться. Символ без адреса возвращается с
None, а не с придуманной строкой; устаревший индекс помечаетсяstaleи пересобирается по контрольной сумме. - Граф различает объявленное и выведенное. 16 552 против 48 617 — это позволяет строить решения только на
stated-рёбрах там, где цена ошибки высока. - Схема базы читается без подключения к базе. Таблицы и колонки извлекаются из миграций, а
write_checkдо запуска SQL называет ближайшие существующие колонки. - Локальность без облака и подписки. Индекс лежит в
.ragrafвнутри проекта; наружу не уходит ничего, кроме явных сетевых операций. - Цена предсказуема. Векторы считаются один раз при индексации, дальше запросы идут по локальным файлам — расход на токены определяется размером ответа, а не размером репозитория.
Установка
Слой знаний ставится отдельно от runtime: сначала индекс, потом подключение к агенту. Требования проверены на версии 0.3.1.
flowchart TB
  P["Python 3.13+"] --> I["git clone · pip install -e ."]
  I --> C["ragraf init: конфиг корпуса"]
  C --> E["правка include и exclude"]
  E --> R["ragraf register + index"]
  R --> D["каталог .ragraf в проекте"]
  D --> S["MCP-сервер в агенте"]
  S --> F["первый запрос symbol"]
| Требование | Значение | Зачем |
|---|---|---|
| Python | 3.13+ | пакет и индексатор |
| Диск | от 1 ГБ на корпус среднего размера | три хранилища SQLite и векторы |
| ОЗУ | 1–2 ГБ на индексацию | модель векторов и разбор AST |
| Опционально | Joern (Java) | межпроцедурный граф; без него — degraded, но с явной причиной |
| Опционально | GPU | только стадия векторов; включается порогом по числу текстов |
git clone https://github.com/paulmann/RAGRAF.git
cd RAGRAF
python -m venv .venv && . .venv/bin/activate     # Windows: .venv\Scripts\Activate.ps1
pip install -e .                                # ставит пакет и команду ragraf
ragraf --version
ragraf init /srv/app/myservice                  # создаёт конфиг корпуса, печатает путь
ragraf -p /srv/app/config/myservice.yaml register
ragraf -p /srv/app/config/myservice.yaml index
ragraf -p /srv/app/config/myservice.yaml query symbol send_invoice
Два упрощения, о которых стоит знать заранее: на Windows установщик scripts/install.ps1 собирает виртуальное окружение в ~/.ragraf/venv и после каждого шага проверяет результат, а если ставить пакет не хочется вовсе — работает обёртка scripts/ragraf.ps1 или прямой вызов python tools/ragraf.py. Пакета в PyPI на 26.10.2026 нет, pip install ragraf не сработает — ставится из репозитория.
Подключение к агенту — это запись в конфигурации MCP-клиента, а не отдельная служба:
{
  "mcpServers": {
    "ragraf": {
      "command": "python",
      "args": [
        "/opt/ragraf/tools/ragraf-mcp.py",
        "--project",
        "/srv/app/config/myservice.yaml"
      ]
    }
  }
}
Установка runtime — отдельный шаг, и здесь нельзя давать общий рецепт: OpenCode ставится пакетом opencode-ai (проверено в npm, версия 1.19.4), Codex CLI — пакетом @openai/codex (0.164.0), DeepSeek Harness — @deepseek-ai/dsh (0.2.1-rc.2), Claude Code — @anthropic-ai/claude-code (2.1.310). AutoClaw и Agent Zero распространяются установщиками с официальных страниц, а OpenClaw требует Node 24+ и ставится как шлюз.
Настройка
Настраивается не «агент вообще», а корпус: что индексировать, чем считать векторы и как часто пересобирать индекс. Файл конфигурации создаёт ragraf init, дальше его правят руками — и это единственное место, где решается, попадёт ли код в индекс.
flowchart LR
  Y["corpus.yaml"] --> L["languages
какие языки в индекс"]
  Y --> X["include / exclude
что не индексировать"]
  Y --> EM["embedding
модель, dim 384, device"]
  Y --> CH["chunking
by_symbol, 120 строк"]
  Y --> IX["index
пороги реиндексации, Joern, GPU"]
  IX --> T1["reindex_after_changes 10"]
  IX --> T2["full_reindex_after_changes 40"]
  IX --> T3["reindex_interval_minutes 30"]
| Ключ | Значение по умолчанию | Что меняет |
|---|---|---|
languages |
по фактическим файлам | какие языки индексируются; язык вне списка выпадает молча |
include / exclude |
типовые шаблоны | что именно попадает в индекс; сопоставление регистрозависимо |
secrets_exclude |
пусто | файлы, которые нельзя индексировать ни при каких условиях |
embedding.model |
paraphrase-multilingual-MiniLM-L12-v2 |
модель векторов, dim = 384 |
embedding.device |
auto |
cpu, cuda:0 или автоматический выбор |
embedding.gpu_min_texts |
1800 | порог, ниже которого карта не включается |
chunking.by_symbol |
true |
нарезка по символам, а не по строкам |
index.retain_revs |
3 | сколько ревизий хранится для отката |
index.reindex_after_changes |
5 (в этом корпусе 10) | сколько правок накапливается до быстрой переиндексации |
index.full_reindex_after_changes |
20 (в этом корпусе 40) | порог полного пересбора с графом |
index.reindex_interval_minutes |
15 (в этом корпусе 30) | возраст индекса, после которого он считается старым |
index.joern_enabled |
true |
межпроцедурный анализ; без Java уходит в degraded |
Фрагмент рабочего конфига корпуса — ровно те ключи, что читает индексатор:
root: /srv/app
languages:
  - python
  - php
  - powershell
  - markdown
exclude:
  - "**/vendor/**"
  - "**/node_modules/**"
embedding:
  model: sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2
  dim: 384
  device: auto
  gpu_min_texts: 1800
index:
  retain_revs: 3
  reindex_after_changes: 10
  full_reindex_after_changes: 40
  reindex_interval_minutes: 30
Подводные камни
- Лицензия ≠ «open source».
n8nживёт под Sustainable Use License (fair-code, файлы с.eeлицензированы отдельно),Dify— под собственной лицензией с запретом multi-tenant SaaS и удаления логотипа,AutoGPT— под PolyForm Shield,Khoj— под AGPL-3.0. Проверять нужно файлLICENSE, а не обзор. - Статусы проектов устаревают быстрее обзоров. В maintenance mode —
microsoft/autogen(релиз 30.09.2025), а неAG2(1.2.1 от 21.10.2026).Microsoft Agent Framework— 1.0 с апреля 2026 для .NET и Python, в preview только Go.LangGraph Platformпереименован вLangSmith Deploymentв октябре 2025. - Адреса репозиториев меняются.
OpenCodeтеперьanomalyco/opencode;Agent Zero—agent0ai/agent-zero. Ссылка на старый адрес ведёт в мир архивных форков. - Домены-двойники. Вокруг
Hermes,DeepSeek HarnessиAutoClawсуществует слой сайтов с похожими именами, которые не являются официальными источниками. Признак официальности — домен вендора и организация на GitHub, а не первая строка поиска. - Выведенные рёбра нельзя считать структурой. 73 % связей в проверенном корпусе — вывод по имени. Строить на них миграции и «полный список вызовов» опасно: одноимённый метод в другом классе даёт ложную связь.
- Внешние символы приходят без адреса. В примере выше
external python:op_write_checkвернулNoneвместо строки: индекс знает только свой корпус. Это ограничение метода, а не дефект, но агент должен уметь на него реагировать чтением файла. - Индекс растёт. Каталог
.ragrafна рабочей машине занимает от сотен мегабайт до гигабайт: хранятся ревизии, журналы и граф..ragrafобязательно попадает в.gitignore— иначе репозиторий распухает, а из истории такие объёмы уже не убрать. - Инструментов может быть слишком много. 59 инструментов в контексте — это расход до начала работы. Подключайте операции выборочно: обычно нужны
symbol,callers,impact,search,write_check,schema.
Чек-лист внедрения
- [ ] Сформулировать слой: что именно нужно — исполнение действий, порядок шагов или факты о коде. Два слоя одновременно одним продуктом не закрываются.
- [ ] Проверить лицензию по файлу
LICENSEи способ запуска: self-hosted, облако или проприетарный продукт. - [ ] Посмотреть дату последнего релиза: полтора года без выпусков — это ответ про поддержку.
- [ ] Поставить слой знаний и проиндексировать корпус:
ragraf init,register,index. - [ ] Проверить ответ на трёх знакомых символах: есть ли ревизия, диапазон строк и границы применимости.
- [ ] Подключить MCP-сервер к агенту и убедиться, что тот видит инструменты, но не все 59 сразу.
- [ ] Настроить пороги реиндексации под темп правок и добавить
.ragrafв.gitignore.

FAQ
Можно ли заменить RAGRAF обычным grep и чтением файлов?
Можно, если корпус маленький и вопросов мало. На корпусе из 861 файла один вопрос «кто вызывает эту функцию» превращается в десятки тысяч строк контекста, а проверяемость ответа остаётся нулевой: в выводе grep нет ни ревизии, ни границ применимости, ни различения объявленных и выведенных связей.
Почему в обзоре нет единого балла для всех платформ?
Потому что балл сравнивает несравнимое: runtime и слой знаний решают разные задачи. Оценка в таблице показывает зрелость продукта в своём классе, а выбор делается по слою, который вам нужен, и по лицензии, которую вы можете принять.
Что выбрать для локального контура без облака?
Связка из трёх частей: runtime (OpenCode, Codex CLI, DeepSeek Harness или AutoClaw), слой знаний (RAGRAF) и, если нужны роли сотрудников, платформа вроде SagaAI. Low-code платформы вроде n8n и Dify добавляются, когда нужны внешние интеграции, а не анализ кода.
Насколько ответам индекса можно доверять?
Настолько, насколько свеж индекс: в каждом ответе есть ревизия и признак устаревания, а расхождение контрольной суммы запускает переиндексацию. Всё, что помечено как derived или external, требует проверки по файлу — это записано в самом ответе.
Нужна ли видеокарта?
Нет. Карта ускоряет только кодирование текста в векторы и включается по порогу (в проверенном корпусе — от 1800 текстов). Построение графа и разбор деревом идут на процессоре, и ускорять их картой бессмысленно.
Что делать, если нужного языка нет в индексе?
Проверить список languages в конфиге корпуса: язык, которого там нет, не индексируется, и это неотличимо от «файлов нет». После добавления языка нужна переиндексация.
Итог
Рынок 2026 года разделился не на «победителей и проигравших», а на слои, и главная ошибка выбора — купить runtime, ожидая от него проверяемых фактов о коде, или поставить слой знаний, ожидая, что он сам будет действовать. Проверенные данные показывают: свободных проектов большинство, но лицензии у них разные; статусы в обзорах отстают на год; а самый недооценённый слой — знания, где ответ обязан нести ревизию, источник и границы. Начните с одного корпуса и трёх знакомых символов: если ответ не проверяется, остальное не имеет значения.
Цитата: Хороший инструмент отличается от умного не тем, что отвечает на всё, а тем, что называет границу, за которой его ответ — догадка.
Связанные материалы
- RAGRAF: графово-векторная база знаний о коде для агентов — подробный обзор слоя знаний: 52 операции, установка, настройка.
- Fail2Ban_AbuseIPDB 1.1.1: отчёты в AbuseIPDB и ключ в файле — пример продукта, который агент сопровождает по индексу.
- Bash WP-CLI Update: обслуживание парка WordPress одной командой — как выглядит автоматизация парка без агентной платформы.
- Репозиторий RAGRAF и документация: github.com/paulmann/RAGRAF.
- Сайт SagaAI: sagai.ru — self-hosted платформа команды ИИ-сотрудников.
LLM Summary
- Тема: обзор 18 решений агентного ИИ по проверенным на 26.10.2026 данным (GitHub API, npm, файлы лицензий, локальные репозитории) плюс разбор трёх слоёв стека.
- Ключевая мысль: runtime, оркестратор и слой знаний — разные слои; единый балл для них некорректен.
- Лицензии: большинство проектов свободные, но
n8n— Sustainable Use,Dify— собственная лицензия,AutoGPT— PolyForm Shield,Khoj— AGPL-3.0,Claude CodeиAutoClaw— проприетарные. - Исправленные статусы: maintenance mode у
microsoft/autogen, а не уAG2;Microsoft Agent Framework— 1.0 (не preview);LangGraph Platformпереименован вLangSmith Deployment. - Форма слоя знаний: каталог
.ragrafв проекте, три хранилища SQLite, векторы 384 измерения, MCP-сервер поверх. - Команды:
ragraf init,register,index,query symbol, подключение через конфиг MCP-клиента. - Замеры: 861 файл, 5 122 узла, 66 875 рёбер (16 552 stated, 48 617 derived), 0,65 с на
symbol, 2,9 с наsearchв новом процессе. - Ограничения: внешние символы без адреса, 73 % рёбер выведены, индекс требует переиндексации при активной разработке.
- Кому: командам, которые дают агенту доступ к большому коду и хотят проверяемых ответов вместо догадок.
- Ссылки: github.com/paulmann/RAGRAF, sysadministrator.ru/ragraf.
Промт для агента (установка и настройка)
Ниже — готовый промт для агента, который ставит слой знаний в проект. Шаги установки взяты из README репозитория, порядок работы с индексом — из AGENTS.md; ссылка на репозиторий — github.com/paulmann/RAGRAF.
Задача: поставить RAGRAF — локальный слой знаний о коде — и подключить его к своему агенту.

Материалы:
- репозиторий: https://github.com/paulmann/RAGRAF
- инструкция для агентов (прочитать первой): https://github.com/paulmann/RAGRAF/blob/main/AGENTS.md
- корпус: /srv/app/myservice — подставьте свой путь

Шаги:
1) Проверить требования: python --version (нужен 3.13+), свободного места не меньше 1 ГБ.
2) Установить из репозитория — пакета в PyPI нет:
   git clone https://github.com/paulmann/RAGRAF.git
   cd RAGRAF
   python -m venv .venv && . .venv/bin/activate     # Windows: .venv\Scripts\Activate.ps1
   pip install -e .
   ragraf --version
3) Создать корпус и проверить списки исключений:
   ragraf init /srv/app/myservice
   # в созданном конфиге проверить languages, include, exclude, secrets_exclude
   ragraf -p /srv/app/config/myservice.yaml register
   ragraf -p /srv/app/config/myservice.yaml index
4) Подключить к агенту через MCP: command=python, args=["/opt/ragraf/tools/ragraf-mcp.py", "--project", "/srv/app/config/myservice.yaml"].
5) Проверить на трёх знакомых символах: ragraf -p /srv/app/config/myservice.yaml query symbol <имя>.
   В каждом ответе должны быть ревизия, диапазон строк и ограничение применимости.
6) Перед любым INSERT/UPDATE вызывать write_check, после правок — query freshness.
7) В отчёт: ревизия индекса, число файлов и рёбер, что проверено вызовом, что осталось гипотезой.