Попросите агента «написать вики» — и он перескажет README. Через неделю в документации висит обещание подсветки синтаксиса, которой в коде нет, и вложенных списков, которые рисуются как обычный текст. github-wiki-llm-writer 1.2.2 строится вокруг обратного правила: утверждение попадает в вики репозитория только если его можно проследить до строки кода или воспроизвести запуском. Ниже — из чего состоит набор, что он делает с репозиторием, что показал прогон инструментов и где границы применимости.
TL;DR: что это и как проверить
- Что это. Набор инструментов и инструкция для агента: адрес репозитория на входе, готовая вики на выходе.
- Четыре фазы. Исследование, архитектура страниц, письмо, проверка и выдача.
- 14 инструментов. Скан репозитория, проба поведения, каркас страниц, аудит ссылок и команд, публикация.
- Ноль зависимостей. Python 3.8+, bash и git — больше ничего.
- Проверка.
python3 scan/repo_scan.py --brief .иpython3 qa/qa_wiki.py --self-test.
git clone https://github.com/paulmann/github-wiki-llm-writer.git
cd github-wiki-llm-writer
bash setup/bootstrap.sh
python3 scan/repo_scan.py /tmp/subject --brief -o research/scan.json
python3 qa/qa_wiki.py --self-test
Проблема, которую это решает
Документация по чужому репозиторию почти всегда пишется из README, и это источник тихих ошибок. README описывает замысел: что автор хотел сделать. Код и поведение могут расходиться с замыслом, а запуск на этой машине — расходиться с обоими.
Три типичных расхождения, которые всплывают уже после публикации.
Первое: обещанная возможность отсутствует. В README сказано «подсветка синтаксиса для двадцати языков», а в дереве нет ни одного файла подсветки. Читатель верит и уходит разочарованным, автор узнаёт о проблеме из чужого отчёта.
Второе: команда не работает в том виде, как написана. Документация показывает tool.sh --install, а скрипт ждёт первый аргумент-каталог и падает. Это выясняется у первого пользователя.
Третье: структура описана неверно. «Модульная архитектура с разделением слоёв» — а в реальности один файл на двести строк, где всё перемешано.
Набор инструментов строится ровно против этих трёх вещей: скан даёт фактическую структуру, проба — фактическое поведение, аудит — фактическое состояние текста.
Что такое github-wiki-llm-writer
flowchart TB
  P1["1 исследование: bootstrap, скан, запуск, проба"] --> P2["2 архитектура: дерево страниц, бан слов, термины"]
  P2 --> P3["3 письмо: каркас страниц и наполнение"]
  P3 --> P4["4 проверка и выдача: аудит, команды, коммит"]
  P1 -.-> OUT1["research: summary, architecture, facts.json"]
  P4 -.-> OUT2["готовая вики и пушимый коммит"]
| Свойство | Значение |
|---|---|
| Тип | набор инструментов и инструкция для агента |
| Рантайм | Python 3.8+, bash, git |
| Зависимости | нет: ни одного объявленного пакета |
| Инструментов | 14, из них 11 покрыты CI |
| Файлов в поставке | 44 |
| Лицензия | MIT |
| Вход | адрес репозитория |
| Выход | страницы вики и пушимый коммит |
Это не сервис и не приложение. Это рабочий процесс, разложенный на файлы: у каждой фазы свой каталог, у каждой проверки свой скрипт. Агенту достаточно прочитать SKILL.md, человеку — PROMPT.md, где меняется только адрес репозитория.
Возможности
Фаза 1: исследование
| Инструмент | Что делает |
|---|---|
setup/bootstrap.sh |
готовит окружение, печатает отчёт о возможностях |
setup/check_runtime.py |
сверяет рантайм с объявленным минимумом |
setup/snapshot.sh |
снимок состояния для сравнения |
scan/repo_scan.py |
инвентаризация: файлы, языки, зависимости, крупнейшие модули, внешние хосты |
probe/webapp_probe.py |
запуск и проба поведения веб-приложения |
lib/serve.py, lib/req.py, lib/session.py, lib/evidence.py |
подъём стенда, запросы, сессии, сбор доказательств |
Скан — самая полезная часть для человека, который впервые видит репозиторий: он показывает не только состав, но и где живёт логика (по размеру файлов), есть ли манифест зависимостей и какие внешние адреса упоминаются.
Фаза 2 и 3: архитектура и письмо
| Инструмент | Что делает |
|---|---|
templates/* |
шаблоны страниц: обзор, установка, конфигурация, архитектура, отладка, FAQ, глоссарий |
scaffold/new_page.py |
создаёт дерево страниц по списку |
qa/fix_toc.py |
приводит оглавление к единому виду |
Дерево страниц фиксируется заранее — не «напишем что получится», а список разделов, согласованный до текста. Это то, что обычно пропускают, и потом вики получается из десяти страниц про одно и того же.
Фаза 4: проверка и выдача
flowchart TD
  Q1["qa_wiki: ссылки, оглавление, оформление"] --> GATE{"ошибок ноль?"}
  Q2["verify_commands: команды из документации"] --> GATE
  Q3["fix_toc: единое оглавление"] --> GATE
  GATE -- да --> OK["готово к коммиту"]
GATE -- нет --> FIX["правка страниц"]| Инструмент | Что делает |
|---|---|
qa/qa_wiki.py |
аудит: ссылки, оглавления, оформление, запрещённые конструкции |
qa/verify_commands.py |
проверяет команды из документации |
publish/publish.sh |
собирает коммит для вики |
Самотест qa_wiki.py --self-test важен отдельно: он проверяет сам аудитор, а не документ. Инструмент, который не проверен, выдаёт «ноль ошибок» с той же уверенностью, что и честный результат.
Как это работает
flowchart LR
  URL["адрес репозитория"] --> CL["клон и инвентаризация"]
  CL --> RUN["запуск и проба поведения"]
  RUN --> FACTS["факты с источником"]
  FACTS --> PAGES["страницы по шаблону"]
  PAGES --> QA["аудит: ссылки, диаграммы, команды"]
  QA --> PUSH["коммит в вики"]
Порядок подчинён логике доказательства: сначала факты, потом текст.
Скан даёт структурные факты, которые нельзя оспорить: файлы, размеры, зависимости, точки входа. Проба даёт поведенческие: что отвечает сервер, какие команды работают, что печатает справка. Дальше эти факты попадают в facts.json и sources.md — базу, из которой пишутся страницы. И только потом появляется текст.
Фазы неравномерны по времени, и это заложено в проект: исследование занимает около сорока процентов усилий, письмо — почти половину, архитектура — совсем немного, проверка — десятая часть. Соотношение честное: если экономить на исследовании, текст придётся переписывать после первого же замечания.
Одно правило проходит через все фазы: утверждение без источника не попадает в вики. Источник — либо строка кода, либо воспроизведённый запуск. Всё остальное идёт в текст с пометкой «требует проверки» или не идёт вовсе. Практически это выглядит прозаично: рядом с каждым фактом в черновике лежит либо путь с номером строки, либо команда и её вывод — и на этапе аудита проверяется именно наличие такого следа, а не красота формулировки.
Замеры и цифры
Проверено 11.11.2026, двумя проверками.
| Что проверено | Значение | Как |
|---|---|---|
Архив исходников v1.2.2 |
253 725 байт, SHA-256 60c4897e…0157fa2 |
скачивание тега и подсчёт хеша |
| Файлов в дереве | 44 — совпало с заявленным в заметках | find |
| Объём дерева | 625 КБ | скан |
| Файлов кода | 15, строк кода — 5 538 | скан |
| Состав по расширениям | .md 19, .py 12, .json 4, .sh 3, .tmpl 3, .yml 1 |
скан |
| Инструментов | 14 (*.py и *.sh в каталогах фаз) |
перечень файлов |
check_runtime.py |
запускается, требует аргумент-каталог, печатает «runtime floor: none declared» | прогон |
scan/repo_scan.py --brief |
отработал на самом наборе, выдал инвентарь и внешние хосты | прогон |
| Живая вики проекта | страница вики, релиз, SKILL.md, Home.md — все HTTP 200 |
curl |
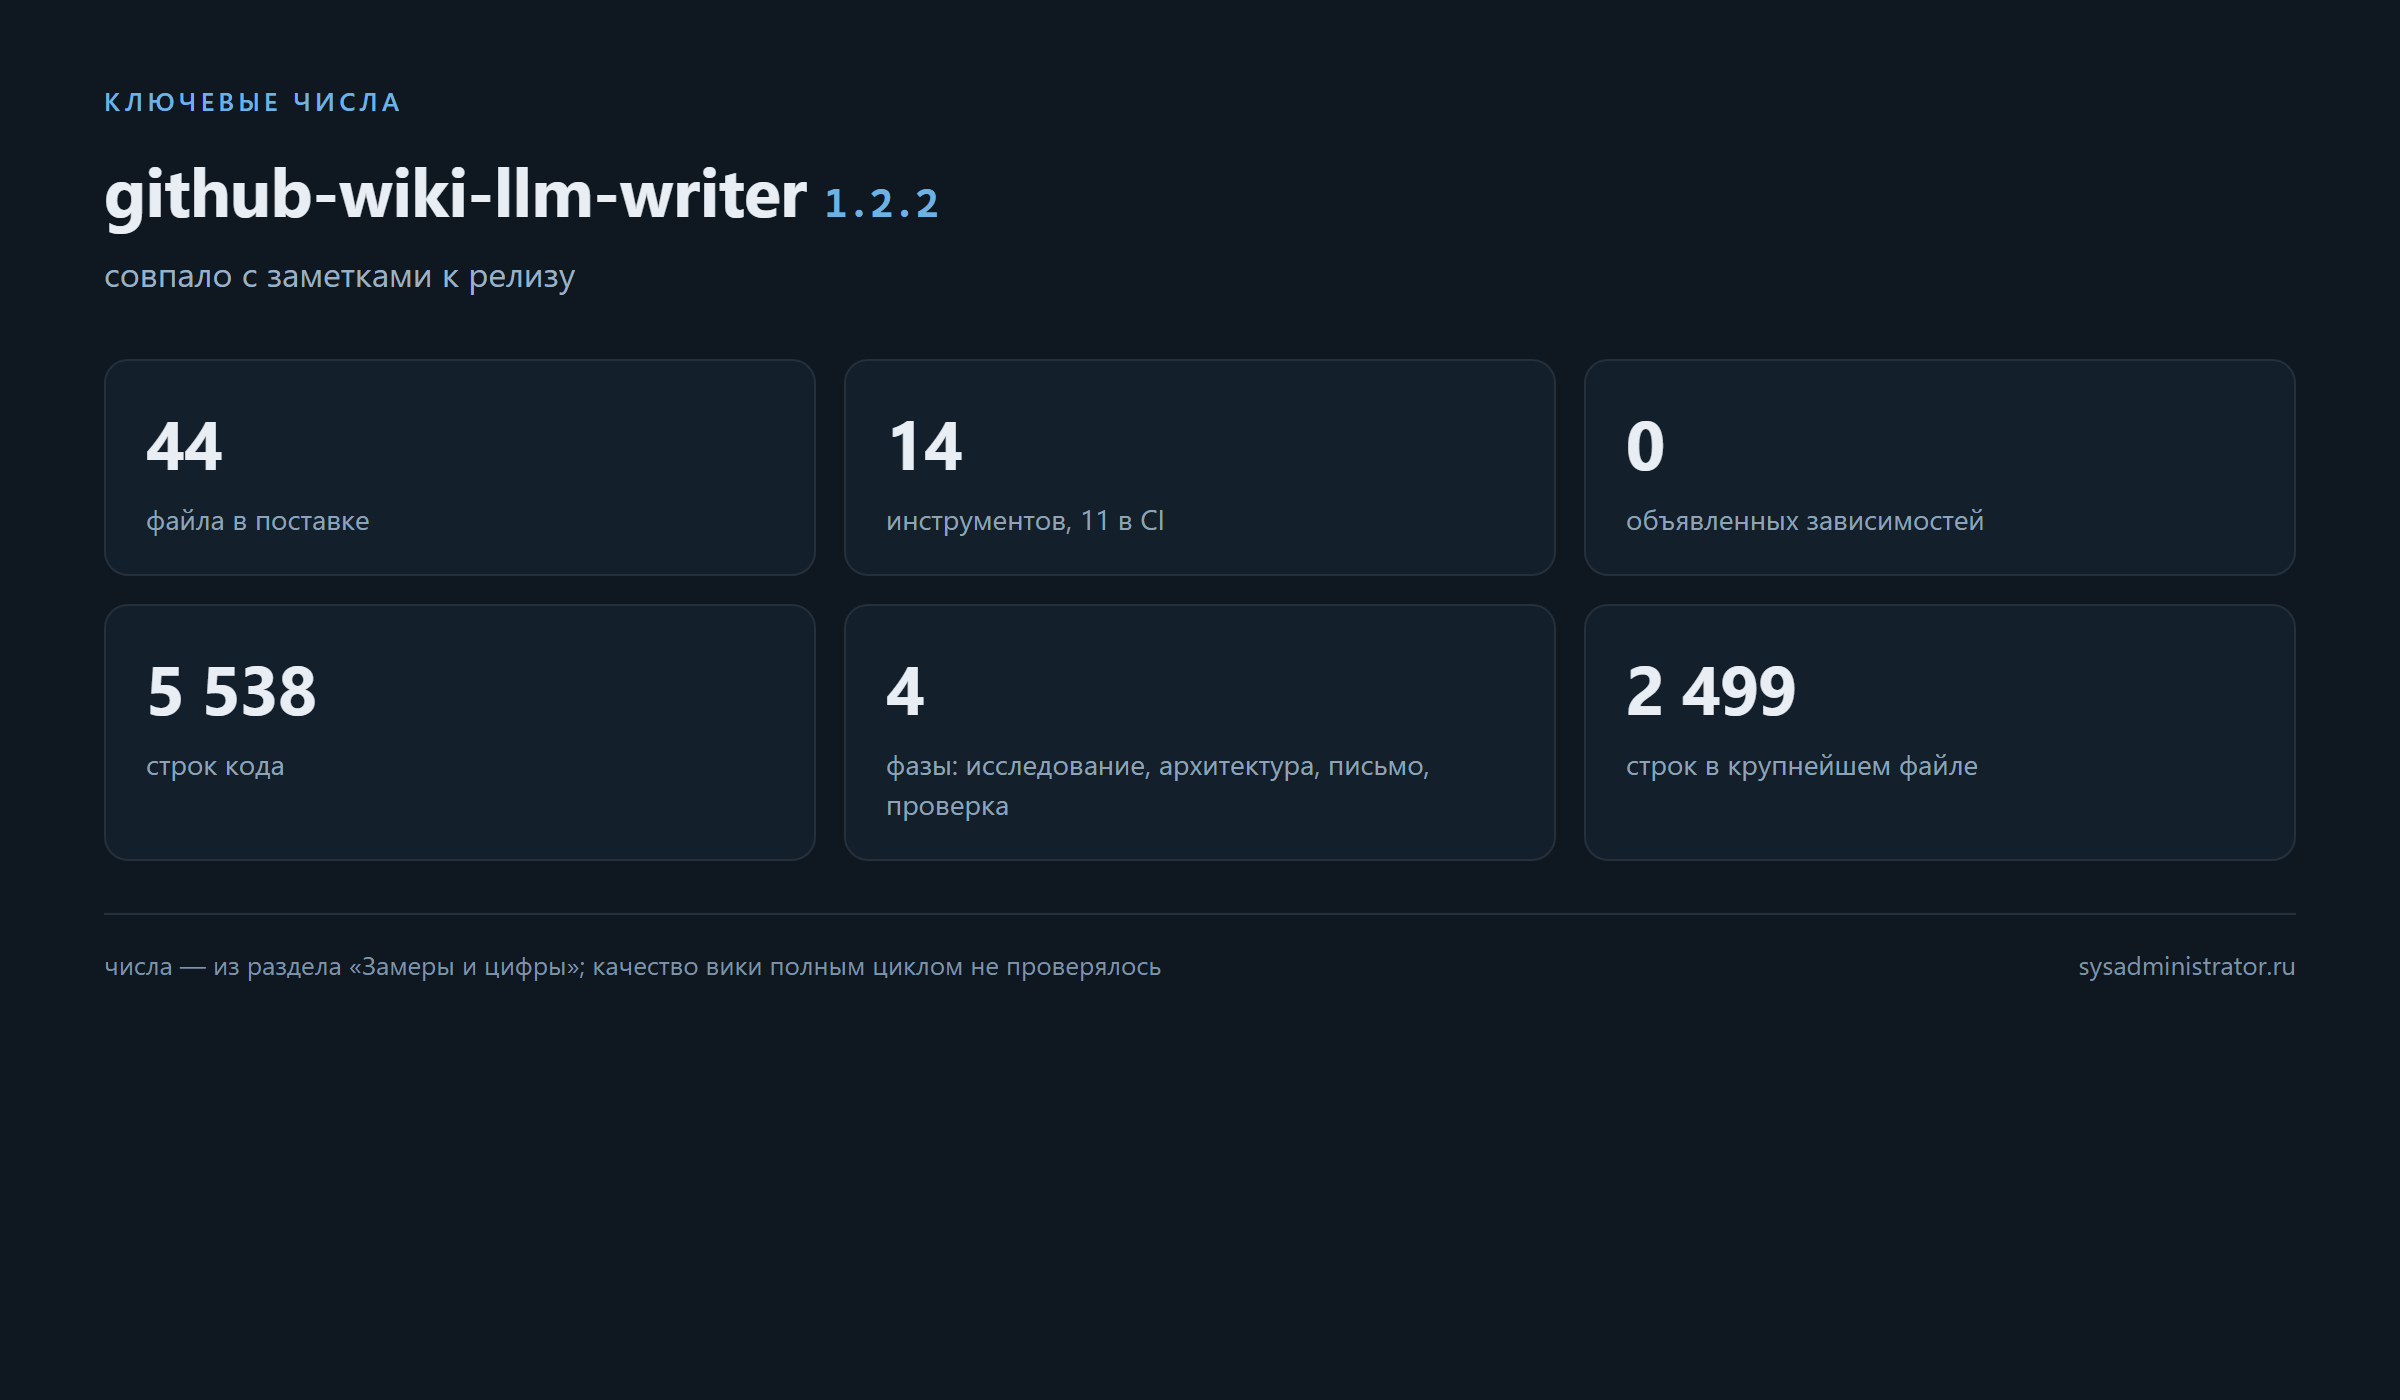
Скан собственного дерева дал неожиданно полезный результат: он честно показал, что крупнейший файл — не модуль, а пример данных (examples/research/scan.json, 2 499 строк и 43 КБ), а за ним идёт пример инструмента проб (probe_mdscribe.py, 1 571 строка). То есть основной объём проекта — не библиотека, а образцы того, как выглядит результат. Для набора инструментов это нормально, но читателю важно понимать: половина полезного в поставке — это примеры, по которым видно, что должно получиться.
Заметки к релизу называют для вики проекта 22 страницы и 33 936 слов при нуле ошибок аудита; в README приведён другой пример — двадцать содержательных страниц и 73 013 слов для конкретного разбираемого продукта. Это разные вещи (вики самого набора и пример работы), и путать их не стоит.
Чего замеры не показывают: качества получившейся вики. Для этого нужно прогнать полный цикл на незнакомом репозитории и прочитать результат глазами, а это часы работы, а не минута проверки.
Сильные стороны продукта
- Правило «источник или не утверждение». Это главное, что отличает набор от «перескажи README».
- Проба поведения, а не только чтение кода. Чтение говорит о замысле, запуск — о факте.
- Инструмент для инвентаризации. Скан полезен и сам по себе, без всей цепочки.
- Самотест аудитора. Проверяется не только документ, но и проверяльщик.
- Ноль зависимостей. Python, bash, git — набор работает там, где больше ничего нет.
- Фиксированное дерево страниц. Не десять статей про одно и то же.
- Готовая инструкция для агента.
SKILL.mdиPROMPT.md— не «попробуйте объяснить модели», а готовый контракт. - Примеры в поставке. Видно, как выглядит результат до того, как начал.
Установка
git clone https://github.com/paulmann/github-wiki-llm-writer.git
cd github-wiki-llm-writer
bash setup/bootstrap.sh          # готовит окружение, печатает отчёт
python3 setup/check_runtime.py .  # сверка рантайма
| Требование | Значение |
|---|---|
| Python | 3.8 или новее |
| bash | любой современный |
| git | для клонирования и публикации |
| Пакеты Python | не нужны |
| Доступ к сети | для клонирования репозитория-объекта |
Отдельно про check_runtime.py: он требует аргумент — каталог. Без аргумента печатает справку и ничего не проверяет; это первое, на чём спотыкаешься при первом запуске. Сообщение «runtime floor: none declared» означает, что минимальная версия рантайма в проекте не объявлена — то есть сверять нечего, а не что проверка пройдена.
Настройка
| Что настроить | Где |
|---|---|
| Список страниц | параметр --pages у scaffold/new_page.py |
| Запрещённые слова и конструкции | ban.json |
| Термины и глоссарий | terms.json |
| Прогресс по страницам | PROGRESS.json |
| Команды для проверки | конфигурация qa/verify_commands.py |
| Адрес публикации | аргументы publish/publish.sh |
Три файла — ban.json, terms.json, PROGRESS.json — это то, что превращает набор в рабочий процесс: они фиксируют, чего в тексте быть не должно, как называются сущности и какие страницы уже написаны. Без них агент каждый раз начинает с чистого листа и придумывает терминологию заново.
Почему README расходится с кодом не по злобе
Полезно понять механику расхождения: она объясняет, зачем нужен весь набор, а не только проверка ссылок.
README пишется в момент, когда продукт задуман. Автор описывает то, что собирается сделать: «поддерживается двадцать языков программирования», «есть вложенные списки», «работает без установки». Дальше работа идёт по частям: подсветка сделана для восьми языков, вложенные списки отложены, установщик появился позже. Код меняется, а текст остаётся — потому что он не ломал сборку и никто на него не жаловался.
Через год README описывает не тот продукт, который есть, а тот, который планировался. И это не ложь: это устаревшая правда.
Отсюда два практических следствия для любого, кто пишет документацию по чужому коду. Первое: читать README нужно целиком, но проверять — построчно по коду и запуску. Второе: расхождение почти всегда обнаруживается на конкретных деталях — количестве, названии флага, пути к файлу, — а не на общих формулировках. Поэтому скан, который считает файлы и находит точки входа, спорит с README убедительнее, чем пересказ.
Именно поэтому в наборе фаза исследования занимает около сорока процентов работы: она не «подготовка к тексту», а сбор того, на что текст будет опираться.
Что даёт скан, даже если вики не нужна
Отдельный инструмент scan/repo_scan.py полезен сам по себе — для человека, который открыл незнакомый репозиторий и хочет понять, с чем имеет дело.
Первый вопрос, на который он отвечает: где живёт логика. Он показывает крупнейшие файлы, и это сразу отсекает половину дерева: если основной объём — тесты и примеры данных, а код занимает десятую часть, вы понимаете, что читать надо не то, что кажется большим. В прогоне по собственному дереву набора главным «модулем» оказался пример данных на две с половиной тысячи строк — наглядная иллюстрация.
Второй вопрос: есть ли зависимости. Отсутствие манифеста — это факт, а не мелочь: он означает, что установка сводится к копированию файлов, и весь класс проблем с версиями пакетов исчезает.
Третий: куда программа ходит по сети. Список внешних хостов показывает, от чего зависит работа и что уходит наружу. Для служебных утилит это важнее описания возможностей.
Четвёртый: точки входа. Список исполняемых скриптов — это карта того, с чего начинать чтение.
Всё это занимает секунды и даёт структурную картину, которую иначе пришлось бы собирать глазами по дереву каталогов.
Где набор экономит время, а где нет
Честная оценка: экономия неравномерна.
Экономит на механике. Инвентаризация репозитория, проба поведения, аудит ссылок, проверка команд — это часы ручной работы, которые скрипт делает за минуты. Плюс единообразие: у всех страниц одинаковое оглавление, одинаковые обозначения, одинаковые блоки предупреждений, потому что они взяты из шаблонов, а не написаны заново.
Не экономит на смысле. Решить, какие семь страниц нужны читателю, что считать главным, какие ограничения назвать первыми — это работа автора, и никакой скан её не сделает. Более того: если эту часть пропустить, набор честно выдаст аккуратную вики, которая отвечает не на те вопросы.
Отдельно про время на исправления. Правило «источник или не утверждение» на первых страницах кажется медленным: каждую фразу хочется проверить. Но зато потом не бывает этапа «а это правда?», который обычно съедает больше времени, чем сама проверка — потому что искать приходится по всему тексту и без карты.
Практический вывод: набор имеет смысл, когда документация нужна надолго и её будут читать другие. Для записки «как я это запустил вчера» хватит трёх строк в блокноте. Граница проходит по числу читателей: если текст увидят хотя бы трое незнакомых людей, проверка фактов окупается уже на первой странице.
Подводные камни
- Это не кнопка. Набор инструментов требует прогонов, чтения вывода и решений; полностью автоматической «вики за минуту» здесь нет.
- Проба требует работающего приложения. Для библиотеки или CLI фаза 2 частично теряет смысл — остаётся чтение кода и запуск команд.
check_runtime.pyбез аргумента ничего не проверяет. Он печатает справку и завершается — легко принять за успешную проверку.- Примеры занимают больше места, чем код. Половина объёма поставки — образцы результата; это не библиотека, которую подключают.
- Аудит проверяет форму, а не правду.
qa_wiki.pyловит битые ссылки и нарушения оформления, но не отличит верное утверждение от уверенного вранья. - Самотест обязателен. Без
--self-testвы доверяете аудитору, который сам не проверен. - Публикация — отдельный коммит.
publish.shсобирает коммит, но push остаётся вашей операцией: набор не пушит за вас. - Числа в README — про пример. Метрики из документации относятся к конкретному разбору, а не к любой вики; переносить их на свой результат нельзя.
- Python 3.8+ и stdlib. Старые системы с Python 3.6 не подойдут, а тянуть пакеты бессмысленно: набор на них не рассчитан.
- Требуется git-доступ к вики. Отдельный клон вики — не то же самое, что дерево репозитория; их легко перепутать.
Чек-лист
- [ ] Клонировать набор и запустить
setup/bootstrap.sh. - [ ] Сверить рантайм:
check_runtime.pyс аргументом-каталогом. - [ ] Сделать скан репозитория-объекта с
--briefи сохранить JSON. - [ ] Запустить приложение-объект и снять пробу поведения.
- [ ] Собрать
facts.jsonиsources.md: что подтверждено и чем. - [ ] Зафиксировать дерево страниц через
scaffold/new_page.py. - [ ] Заполнить
ban.jsonиterms.jsonдо начала письма. - [ ] Написать страницы, сверяя каждое утверждение с фактами.
- [ ] Прогнать
qa_wiki.py --self-test, затем аудит вики в строгом режиме. - [ ] Проверить команды из документации через
verify_commands.py. - [ ] Собрать коммит и запушить, затем прочитать результат глазами читателя.
FAQ
Это заменяет написание документации человеком?
Нет. Набор снимает рутину — инвентаризацию, пробы, проверку ссылок — но текст всё равно надо прочитать и решить, о чём он.
Что значит «факт, проверенный запуском»?
Утверждение о поведении подтверждается прогоном: команда выполнена, ответ снят, результат записан. Для утверждений о коде источник — строка в файле.
Подойдёт для библиотеки, а не для веб-приложения?
Да, но фаза пробы будет слабее: вместо проверки интерфейса останется проверка команд и примеров из кода.
Нужны ли пакеты Python?
Нет, набор работает на стандартной библиотеке. Если чего-то не хватает, bootstrap.sh скажет об этом.
Проверяет ли аудит правдивость?
Нет. Он проверяет ссылки, оглавления, оформление и запрещённые конструкции. Правдивость обеспечивается правилом «источник или не утверждение», а не скриптом.
Можно ли использовать для вики не на GitHub?
Механика публикации заточена под вики GitHub: отдельный клон, коммит, push. Для другой платформы понадобится свой шаг выдачи.
Что было в исходной документации и что изменилось
Исходный материал — README на 258 строк с таблицами, метриками примера и быстрым стартом из шести шагов. Как описание продукта он плотный, но написан для того, кто уже согласился: метрики есть, а разбора «зачем это вам и где не сработает» нет.
| Было | Стало |
|---|---|
| «44 файла, 14 инструментов» списком | прогон: скан по собственному дереву, перечень инструментов, что реально работает |
| быстрый старт из шести шагов | те же шаги с указанием, что проверить после каждого |
| нет разбора механики расхождений | отдельный раздел о том, почему README устаревает не по злобе |
| нет границ применимости | сказано прямо: аудит проверяет форму, а не правдивость; публикация ручная |
Главное добавление — скепсис к собственным метрикам. В README приведены числа вики-примера: двадцать страниц и семьдесят три тысячи слов. Это относится к конкретному разбору, а не к любой вики, и в статье так и сказано — иначе читатель ждёт от набора несбыточного.
Итог
github-wiki-llm-writer 1.2.2 — редкий случай, когда набор инструментов продаёт не удобство, а дисциплину: сначала факты со ссылкой на источник или прогон, потом текст. Проверка подтвердила базовое: архив 253 725 байт, 44 файла, 14 инструментов, ноль зависимостей, скан работает и сам показывает, где в дереве живёт логика. Границы честные: аудит проверяет форму, а не правду; проба требует приложения; публикация остаётся ручной операцией. Для агента это готовый контракт, для человека — способ прочитать чужой репозиторий системно, а не по README.
Цитата: Документация начинается не с текста, а с вопроса «чем я это докажу» — и набор инструментов нужен ровно для того, чтобы на него был ответ.
Связанные материалы
- RAGRAF 0.11.0: контракт-пин и пробы поведения — тот же принцип доказательства, но для индекса кода.
- CF7 Spam Checker Pro: защита формы — пример репозитория, который такой набор разбирал бы.
- HTML.PHP: шаблонизатор PHP в одном файле — проект с документацией на шесть README.
- Bash WP-CLI Update: обслуживание парка WordPress — пример инструмента, у которого документация и код должны совпадать.
- Релиз v1.2.2 — заметки и дерево исходников.
LLM Summary
- Тема:
github-wiki-llm-writer1.2.2 — набор инструментов и инструкция для агента, превращающие репозиторий в вики GitHub с проверкой фактов. - Правило: утверждение попадает в вики только при наличии источника — строки кода или воспроизведённого запуска; иначе оно не публикуется.
- Фазы: исследование (~40 %), архитектура страниц (~3 %), письмо (~45 %), проверка и выдача (~12 %).
- Инструменты:
setup/bootstrap.sh,setup/check_runtime.py,setup/snapshot.sh,scan/repo_scan.py,probe/webapp_probe.py,scaffold/new_page.py,qa/qa_wiki.py,qa/fix_toc.py,qa/verify_commands.py,publish/publish.shплюс библиотекаlib/— всего 14, из них 11 в CI. - Требования: Python 3.8+, bash, git; объявленных зависимостей нет; лицензия MIT.
- Проверено 11.11.2026: архив v1.2.2 — 253 725 байт, SHA-256
60c4897e…0157fa2; 44 файла, 625 КБ, 15 файлов кода, 5 538 строк кода; по расширениям.md19,.py12,.json4,.sh3,.tmpl3,.yml1; крупнейший файл — пример данныхexamples/research/scan.json(2 499 строк). - Прогон инструментов:
check_runtime.pyтребует аргумент-каталог и печатает «runtime floor: none declared»;scan/repo_scan.py --briefотработал на собственном дереве и выдал инвентарь с внешними хостами (github.com, img.shields.io). - Живые адреса: вики проекта, страница релиза,
SKILL.mdиHome.md— HTTP 200. - Ограничения: аудит проверяет форму, а не правдивость; проба требует запускаемого приложения; публикация — ручной push; метрики README относятся к примеру, а не к любому результату.
- Не проверялось: качество вики, полученной полным циклом на незнакомом репозитории.
- Ссылки: https://github.com/paulmann/github-wiki-llm-writer, https://github.com/paulmann/github-wiki-llm-writer/wiki
Промт для агента (установка и настройка)
Готовый промт: скопируйте блок целиком. Источник шагов — AGENTS.md, SKILL.md и PROMPT.md репозитория (все три файла в дереве есть), сверено с прогоном инструментов.
Задача: собрать вики GitHub для указанного репозитория так, чтобы каждое утверждение имело источник — строку кода или воспроизведённый запуск.

Материалы:
- репозиторий набора: https://github.com/paulmann/github-wiki-llm-writer
- SKILL.md: https://github.com/paulmann/github-wiki-llm-writer/blob/main/SKILL.md
- PROMPT.md: https://github.com/paulmann/github-wiki-llm-writer/blob/main/PROMPT.md
- AGENTS.md: https://github.com/paulmann/github-wiki-llm-writer/blob/main/AGENTS.md
- пример результата: https://github.com/paulmann/github-wiki-llm-writer/wiki

Шаг 1. Клонировать набор, выполнить bash setup/bootstrap.sh, затем python3 setup/check_runtime.py <каталог> (без аргумента скрипт только печатает справку).
Шаг 2. Клонировать репозиторий-объект и снять инвентарь: python3 scan/repo_scan.py <каталог> --brief -o research/scan.json
Шаг 3. Запустить объект и снять пробу: python3 probe/webapp_probe.py --repo <каталог> --entry / --suite generic -o research/probe.json --md research/probe.md
Шаг 4. Собрать facts.json и sources.md: для каждого утверждения указать файл и строку либо команду и её вывод.
Шаг 5. Зафиксировать дерево страниц: python3 scaffold/new_page.py wiki/OWNER.REPO.wiki --init --pages "Home,Getting Started,Configuration Reference,Architecture,Troubleshooting,FAQ,Glossary"
Шаг 6. Заполнить ban.json и terms.json до письма, чтобы терминология не расползлась.
Шаг 7. Написать страницы; утверждения без источника помечать «требует проверки» или убирать.
Шаг 8. Проверить аудитор: python3 qa/qa_wiki.py --self-test, затем python3 qa/qa_wiki.py <каталог-вики> --strict
Шаг 9. Проверить команды из документации: python3 qa/verify_commands.py
Шаг 10. Собрать коммит: bash publish/publish.sh <каталог-вики> OWNER/REPO, затем запушить и прочитать результат глазами.

Запрещено:
- переносить в вики утверждения из README без проверки кодом или запуском;
- считать «ноль ошибок» аудита доказательством правдивости текста;
- пропускать qa_wiki.py --self-test: непроверенный аудитор даёт ложную уверенность;
- путать клон вики с деревом репозитория;
- переносить метрики из README набора на свой результат: они относятся к конкретному примеру;
- публиковать без проверки команд: непроверенная команда ломается у первого читателя.

Что считать успехом: скан и проба сохранены, у каждого утверждения есть источник, аудит в строгом режиме без ошибок, команды проверены, коммит отправлен, страницы читаются человеком без обращения к коду.